皮肤过敏性整合测试与评估方法(Defined Approaches for Skin Sensitisation, 简称 DA)指南
OECD 指南 497
OECD, 测试指南, 毒理学, 皮肤致敏, 定义方法
文档信息
| 属性 | 内容 |
|---|---|
| 指南编号 | 第497号 |
| 发布日期 | 2025年6月25日 |
| 文档类型 | OECD测试指南 |
| 主题 | 皮肤致敏性定义方法 |
| 章节 | 第4节 - 健康效应 |
1. 引言
1.1. 背景
OECD497,全称为《皮肤致敏性整合测试与评估方法指南》(Guideline on Defined Approaches for Skin Sensitisation),是全球首个获得国际监管认可的、完全基于非动物实验数据(In Silico & In Vitro)来判定化学品皮肤致敏性的法律框架。该指南的发布标志着毒理学评估从依赖“活体动物经验”向基于“人体细胞机制”的生物医学范式转变。
通过将多种体外实验数据与计算机预测模型深度融合,OECD497为全球化学品、化妆品及其原料的合规性评估提供了一套标准化、定量化且具有高度预测性的技术方案。
皮肤致敏物是指根据联合国全球化学品统一分类和标签制度(UN GHS)的定义,在反复皮肤接触后会导致过敏反应的物质。对于皮肤致敏的潜在关键生物事件已有普遍共识。目前关于由蛋白质共价结合引发的皮肤致敏相关的化学和生物学机制知识,已被总结为不良结局通路(AOP)。该通路始于分子起始事件,经过中间关键事件(KEs),最终导致不良效应——过敏性接触性皮炎。
- 皮肤致敏AOP关注的是与氨基酸残基(即半胱氨酸或赖氨酸)发生反应的化学物质,如有机化合物。在这种情况下,分子起始事件(即第一个KE)是亲电物质与皮肤蛋白质中亲核中心的共价结合 OECD442C
- AOP中的第二个KE发生在角质形成细胞中,包括炎症反应以及与特定细胞信号通路(如抗氧化/亲电物质反应元件(ARE)依赖性通路)相关的基因表达变化 OECD442D
- 第三个KE是树突状细胞的活化,通常通过特定细胞表面标志物、趋化因子和细胞因子的表达来评估 (OECD442E)
- 第四个关键事件是T细胞增殖,不良结局表现为过敏性接触性皮炎
基于机制的化学法和体外试验方法(OECD TG 442C、442D、442E)上述单独的实验方法不被认为是动物数据的充分独立替代方法,无法单独用于判断化学品的皮肤致敏潜力,也无法提供根据UN GHS进行效力亚分类(亚类1A和1B)的信息,除动力学直接多肽反应性试验(k-DPRA)
皮肤致敏的评价通常涉及实验动物的使用。
- 使用豚鼠的经典方法——豚鼠最大化试验(GPMT)和Buehler试验(OECD TG 406)可评估皮肤致敏的诱导和激发两个阶段
- 小鼠试验,如局部淋巴结试验(LLNA)(OECD TG 429)及其三种非放射性改良方法——LLNA: DA(OECD TG 442A)、LLNA: BrdU-ELISA和BrdU-FCM(OECD TG 442B)——仅评估诱导阶段,由于在动物福利方面优于豚鼠试验,同时可对皮肤致敏的诱导阶段进行客观测量
1.2 Defined Approaches
Defined Approaches(规定性方法/明确定义的方法)
DA由固定的数据解释程序(DIP)(例如数学模型、基于规则的方法)应用于由一组确定的信息源生成的数据(例如计算预测、化学法数据、体外数据),在无需专家判断的情况下得出预测结果。
DA更像是一套标准流程,有着各种约束条件
- 固定的信息来源:使用一组预先定义好的数据来源,通常包括计算机模拟评价(in silico)、体外化学分析法(in chemico)和体外试验(in vitro data)
- 固定的数据解释程序(DIP):采用数学模型或基于规则的方法来解释上述数据。这种解释过程是透明的、标准化的,其最大特点是不需要依赖专家的主观判断即可得出预测结论
- DA的最终目标是提供与动物研究相当的信息,即可用于危害鉴定、效力(亚)分类和/或致敏效力的定量测量(用于推导起始点(PoD))的信息
在进行基于体内(如LLNA)试验、化学法试验、体外试验、计算预测方法、DA或其任意组合输出的危害评价、效力(亚)分类和/或PoD预测时,始终适用相同的原则。即应考虑与所涉及化学品相关的所有可用信息,以及结构相关受试化学品的毒理学数据
本指南主要分为三部分:
- 第一部分:危害鉴定,即区分皮肤致敏物和非致敏物(第一部分)
- 第二部分:效力亚分类(第二部分)
- 第三部分:推导起始点(第三部分)
第二部分中包含的DA也适用于危害鉴定(第一部分), 第三部分中包含的DA不能用于第一部分或第二部分,除非是特别说明用途
包含196种化学品的综合数据集,包括DA预测、各信息源数据、经过严格筛选的LLNA和人体斑贴预测试验(HPPT)数据以及理化性质,已编制完成并作为皮肤致敏性定义方法(DA)指南
- 168种化学品有基于LLNA数据的分类
- 66种化学品有基于人体数据的分类
该数据集主要包含化妆品成分,但也包括跨行业使用的其他类型化学品,如防腐剂、染料或食品成分。该数据集具有化学多样性,这可以从这些化学品所涵盖的理化性质范围得以体现:包含小分子和大分子(分子量范围为30至512 g/mol)、亲水性和疏水性物质(Log P范围为-3.9至9.4)、液体和固体(熔点范围为-122至253°C)、挥发性和非挥发性物质(沸点范围为-19至445°C)
更多的空间表征细节
1.3 指南发展
最初通过,包含的DA是使用特定方法组合开发的,即直接多肽反应性试验(DPRA)、KeratinoSens™和人细胞系活化试验(h-CLAT),用于”2选3”方法(2o3)
综合测试策略(ITS): DPRA、h-CLAT和Derek Nexus或OECD定量构效关系((Q)SAR)Toolbox,用于起始点 – 从实验数据建立的剂量-反应曲线上确定用于推导安全水平的点
在评估和开发第一批DA和特定信息源的过程中,EG DASS成员开展了多项分析工作。这些工作包括为每个DA起草评估框架,建立、筛选和表征人体和小鼠数据的化学参考清单,以及开发决策树和其他工具,将计算预测信息源纳入相关DA和指南中。该专家组还确定了DA和信息源的不确定性来源和潜在局限性,以及临界试验结果,并评估了这些因素对DA性能的影响
Annex 2 — DASS 数据库(Excel 文件):这是一个 Excel 格式的数据附件,包含支持 TG 497 各定义方法(DASS)评估的底层数据表:196 种参考化学品的各信息源数据(in chemico / in vitro 试验结果、计算预测结果)、DA 预测输出、经筛选的 LLNA 和人体斑贴试验(HPPT)参考分类数据以及理化性质。指南中报告的准确率、灵敏度、特异度等性能指标都可以在这个数据表中溯源和重现。OECD 官方在支持文件里也明确写了 “Please refer to Annex 2 … for detailed information”
Annex 9 — “相似方法”(Similar Methods)性能评估 / 2025 更新支持信息: 相似方法性能评估:评估与已验证方法“相似”的替代试验方法(similar methods,例如与 KeratinoSens™ 类似的 LuSens、与 h-CLAT 类似的方法等)在 2o3 / ITS 等 DA 框架下的预测性能,其完整数据表同样引用 Annex 2 的 Excel 文件。
Derek Nexus 是一款在毒理学领域极具权威性的基于专家知识规则的毒性预测软件系统。它主要通过分析化学物质的分子结构特征(如警示结构),来预测其潜在的毒性终点,被全球多家监管机构(如美国FDA、欧洲EMA、中国NMPA等)广泛认可
本指南第一部分和第二部分中描述的所有DA均可用于满足各国区分致敏物(即UN GHS第1类)和非致敏物(UN GHS未分类(NC))的要求,尽管它们的灵敏度和特异度各不相同
ITS DA 还可用于将化学品区分为三个UN GHS效力类别(第1A类 = 强致敏物;第1B类 = 其他致敏物)和NC
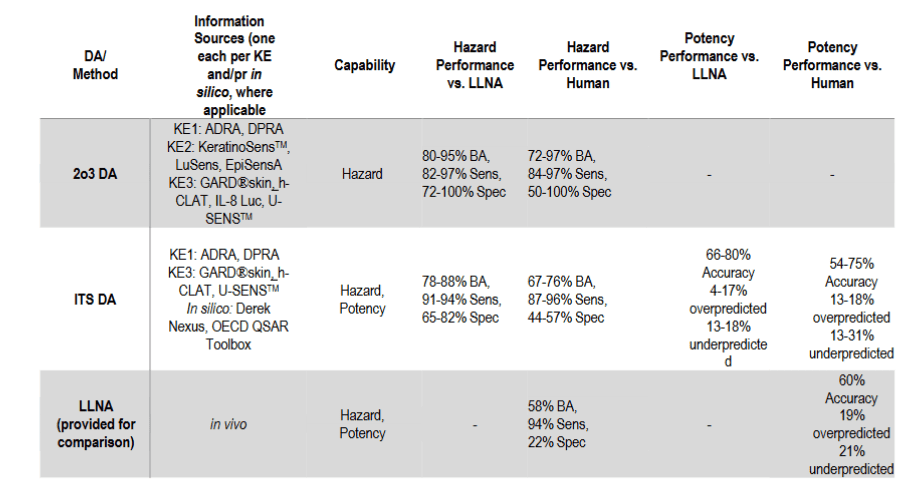
由于阴性参考化学品数量较少,特异度测量值比灵敏度测量值更不确定,表分别显示了所有2o3和ITS DA排列组合相对于LLNA参考数据和基于人体的参考数据的危害分类平衡准确率(BA)和效力分类准确率(Acc)
准确率(accuracy)反映了所有联合国全球化学品统一分类和标签制度(UN GHS)子类别(1A类 = 强致敏物;1B类 = 其他致敏物;以及未分类(NC))的总体正确分类率。过度预测(Overprediction)是指化学物质被错误地分类为具有更强的致敏效力,例如:将未分类(NC)的物质预测为 1A/1B 类,或者将 1B 类致敏物预测为 1A 类。预测不足(Underprediction)则是指化学物质被错误地分类为具有较弱的致敏效力,例如:将 1A 类致敏物预测为 1B/NC 类,或者将 1B 类致敏物预测为 NC 类
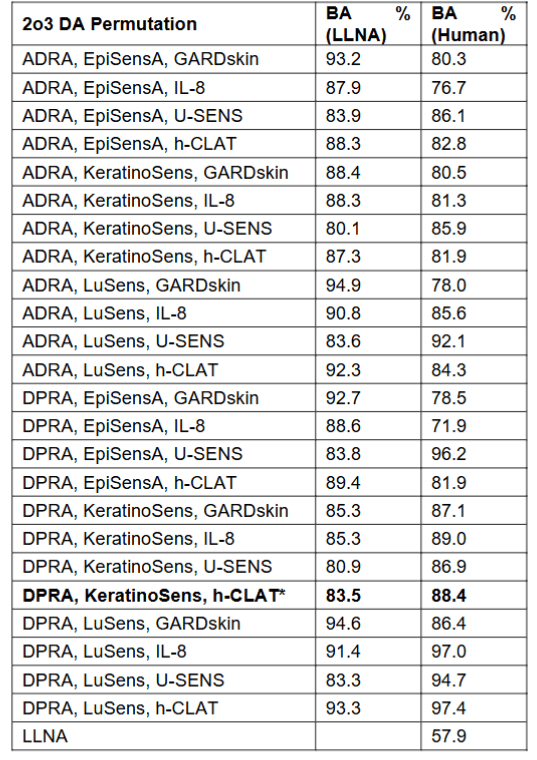
上图展示了每种 2o3 DA 排列组合基于最大公共数据集评估的准确率,对比LLNA和人-base 参考数据库
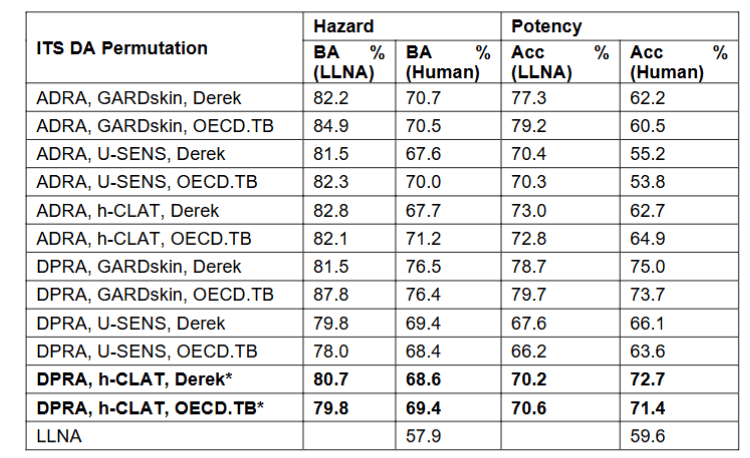
上图展示了每种 ITS DA 排列组合基于最大公共数据集评估的准确率,OECD.TB(OECD QSAR Toolbox)
- 第三部分,皮肤过敏风险评估——综合化学环境(SARA-ICE)定义方法,这是一种贝叶斯统计模型,用于基于化学法(KE1)、体外(KE2/KE3)和/或(已有的)体内(KE4/AO)数据推导定量起始点; 第三部分中的 SARA-ICE DA 允许使用来自 LLNA 或人类预测性斑贴试验的现有体内数据;不应为在该 DA 中使用而生成的新的体内数据
SARA-ICE 是一个贝叶斯统计模型,用于估计一个概率分布,从中可以推导出用于皮肤致敏使用特定 2o3 或 ITS DA 排列组合的所有可用数据点的数据集。SARA-ICE 模型通过计算得出一个“致敏剂量(ED01)”的分布范围,但为了防止数值无限大或失去实际意义,模型设定了一个 60,000 µg/cm² 的“天花板”。最终用于风险评估的起始点,是这个被“天花板”截断后的剂量分布的几何平均值
SARA-ICE DA 第三部分允许使用现有的 LLNA 体内数据或来自人类预测性斑贴试验的数据;不应生成新的体内数据用于此 DA
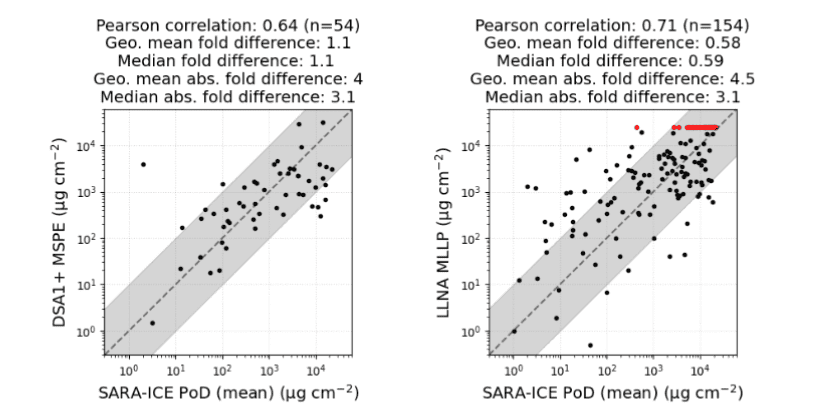
SARA-ICE 算出来的“致敏风险起始剂量 PoD”,到底和真实的人体/动物致敏效力有多接近?SARA-ICE 的定量验证(quantitative validation).对一批已知化学物质,用 SARA-ICE 根据 DPRA + KeratinoSens + h-CLAT 等 NAM 数据计算 PoD,然后把这些 PoD 与独立的人体参考值 MSPE 和动物 LLNA MLLP 比较。结果显示,两者存在明显正相关;约 80%–85% 的 SARA-ICE PoD 与参考值处于 10 倍以内,约 1/3 处于 2 倍以内.
局限性:
某些类型的化学品,如金属、无机化合物、亲脂性物质、成分不明或可变的物质、复杂反应产物和生物材料(UVCB)以及混合物,可能不在某些试验方法的适用域内。在考虑测试混合物、难以测试的化学品(例如不稳定的化学品)或不在适用域内的测试化学品时,应事先考虑此类测试的结果是否具有科学意义
处于临界范围内的单个试验结果可能产生不确定的 2o3 DA 预测,阳性或阴性检测结果若落在这些基准范围和/或个别检测方法的局限性范围内,则置信度较低,可能导致 2o3 DA 预测结果不确定。
OECD QSAR 验证原则之一涉及定义的适用域。适用域是模型以给定可靠性进行预测的反应和化学结构空间,因此适用域应考虑模型的参数空间、结构空间、机制空间、代谢空间和反应空间
2. 皮肤致敏危害鉴定(2o3)方法
“三选二”(2o3)DA旨在不使用动物试验的情况下鉴定化学品的皮肤致敏危害(即 UN GHS Cat. 1 与 UN GHS NC)。该数据解释程序(DIP)目前不用于提供皮肤致敏物效力方面的信息
2o3 DA中包含的测试方法组合覆盖了导致皮肤致敏的AOP前三个KE中至少两个,即 KE1:蛋白质结合(OECD TG 442C)(2);KE2:角质形成细胞活化(OECD TG 442D)(3);KE3:树突状细胞活化(OECD TG 442E)(4)
DIP要求从涵盖皮肤致敏AOP前三个KE中至少两个KE的方法中获得两个一致的结果,以确定最终分类.经典2o3 DA经过评估,使用的精选数据集包括最多168种具有LLNA参考数据的化学品和最多66种具有人体参考数据的化学品,这些数据经EG DASS认可(EG DASS 指的是由国际权威机构(如经合组织 OECD)专门成立的“皮肤致敏定义方法专家组”)
2o3 DA中的DIP是一种透明的、基于规则的方法,不需要专家判断。该方法通过按未定义顺序依次进行最多三个对应KE1-3的国际公认非动物试验来预测皮肤致敏危害。换言之,首先进行两个KE的试验,如果这两个试验结果一致,则据此将化学品预测为皮肤致敏物或非致敏物。如果前两个试验结果不一致,则进行剩余KE的试验。最终结果基于两个一致的发现,并考虑如所述的所获预测的置信度。
KE1(氨基酸衍生物反应性测定法(ADRA)、直接肽反应性测定法(DPRA);TG 442C):皮肤致敏物通常具有亲电性,可与蛋白质的亲核基团发生反应。ADRA和DPRA测量含半胱氨酸或赖氨酸残基的两种肽/氨基酸因共价结合而导致的消耗。(如果肽消耗检测结果处于临界值,则应进行额外检测)
KE2(EpiSensA、LuSens、KeratinoSens™;TG 442D):角质形成细胞的活化通过以下方式证实:a)携带通过Nrf2-Keap1通路的报告基因构建体的人源永生化角质形成细胞的反应(KeratinoSens、LuSens),或b)在重建人表皮模型中定量与角质形成细胞活化相关的标志基因表达变化(EpiSensA)
KE3(基因组过敏原快速检测法(GARD®Skin)、人细胞系活化试验(h-CLAT)、白细胞介素-8报告基因试验(IL-8 Luc)、U937细胞系活化试验(U-SENS);TG 442E):抗原呈递细胞的活化通过以下方式表征:a)暴露于致敏物后与单核细胞和DC活化过程相关的细胞表面标志物表达变化(如CD86、CD54;h-CLAT、U-SENS),b)与DC活化相关的细胞因子IL-8表达的变化(IL-8 Luc),或c)终点特异性基因组生物标志物特征(GARD®skin)
此外,检测结果会受到变异性的影响(例如,由于细胞反应的轻微波动),这些变异性会增加检测结果的不确定性,尤其是在接近(分类)临界值时。
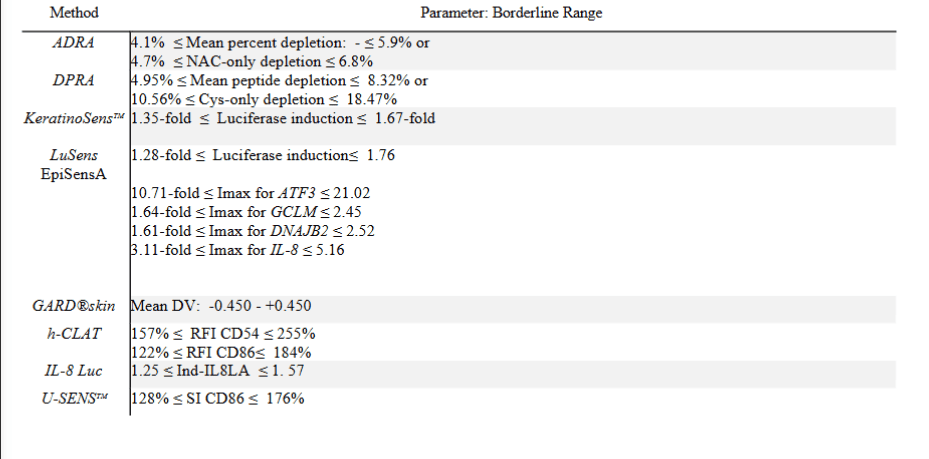
在验证研究中,同一个化学物质被不同实验室、不同重复实验测量,在真实 assay variability 下,1.5 附近的数据会怎么波动,核心使用的是 log pooled median absolute deviation(log pooled MAD)
2.1 如何判断
落入这些BR (Borderline Range) 范围内的阳性和阴性试验结果,以及因化学法/体外TG的局限性导致的不确定结果,均具有较低置信度,并影响2o3 DA的结果
如果2o3 DA中某一试验方法的结果落入该方法的BR内,但组成2o3 DA的另外两个试验方法结果一致且具有高置信度(即结果在各自BR范围之外),则仍可作出2o3 DA预测
如果某一试验方法的结果因局限性或化学品超出该方法的适用域而被视为不确定结果,但组成2o3 DA的另外两个试验方法结果一致且具有高置信度(即结果在各自BR范围之外),则仍可作出2o3 DA预测
如果2o3 DA中某一试验方法的结果落入该方法的BR或存在局限性,且组成2o3的另外两个方法未提供一致且高置信度的结果,则2o3 DA预测被视为”不确定”。这些不确定预测仍可在证据权重方法中和/或在IATA框架内与其他信息源一并考虑.根据预期用途(包括监管要求),高于预测模型决策阈值的临界范围内结果仍可被视为阳性;在此情况下,两个阳性结果可得出总体阳性(致敏物)预测
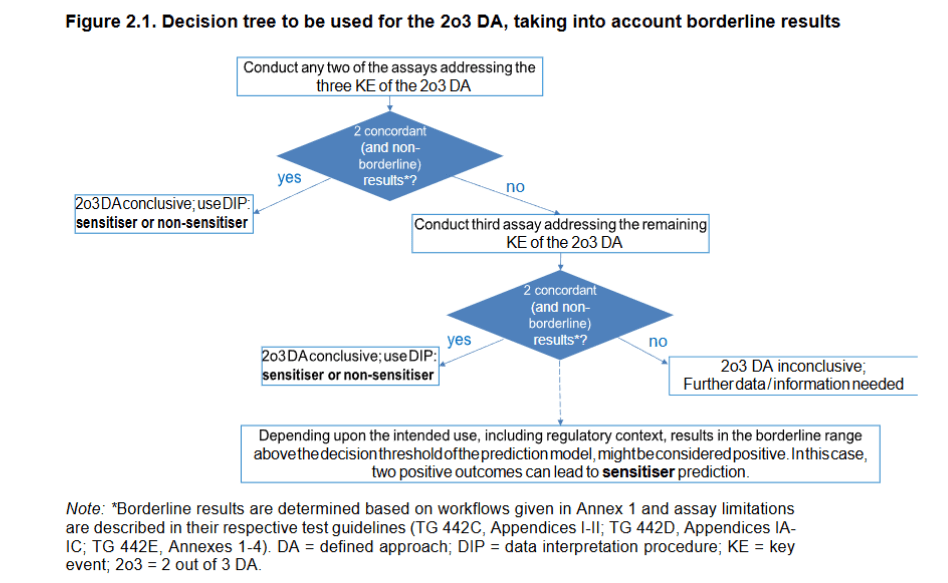
- 第一步:先执行任意两个针对2o3 DA中三个KE的测试
- 第二步:判断这两个测试结果是否“一致且非临界”(2 concordant and non-borderline)
- 如果是 → 直接得出结论:使用DIP(数据解释程序)判定为“致敏物”或“非致敏物”
- 如果否 → 进入第三步,补做第三个KE的测试
- 第三步:执行第三个测试后,再次判断是否有“两个一致且非临界”的结果
- 如果是 → 同样使用DIP得出结论
- 如果否 → 结论为“2o3 DA不明确”,需要进一步数据或信息
在特定监管或使用背景下,若结果处于“临界范围”但高于决策阈值,且有两个阳性结果,可考虑判定为“致敏物”
| 指标 | 范围 |
|---|---|
| 准确率(%) | 81-95% |
| 灵敏度(%) | 82-97% |
| 特异度(%) | 72-100% |
| 平衡准确率(%) | 80-95% |
| 指标 | 范围 |
|---|---|
| 准确率(%) | 83-95% |
| 灵敏度(%) | 84-97% |
| 特异度(%) | 50-100% |
| 平衡准确率(%) | 72-97% |
所有的LLNA和人数据来演都是阴性数据少,导致特异性低的问题
3. 皮肤过敏定义方法–过敏效力分类(致敏强度分级)
本测试只能包括可将皮肤致敏物分类为UN GHS亚类别1A(强致敏物)或亚类别1B(其他中效至弱效皮肤致敏物)的定义方法。这些DA也可用于区分致敏物(UN GHS Category 1)和非致敏物(无分类;NC),以进行危害鉴定
该定义方法构建为整合测试策略(ITS),用于预测皮肤致敏危害潜能和按照UN GHS(亚类别1A和1B)分类体系进行效力亚分类 不是 ITS 认为 KE2 没用,而是经典 ITS 选择 KE1 + KE3,是因为这两个信息在“信息增量”和“独立性”上更适合作为组合输入
ITS DA使用的测试方法涵盖导致皮肤致敏的不良结局通路(AOP)中的关键事件(KE)1和3:
- KE1:蛋白质结合(TG 442C)
- KE3:树突状细胞活化,由OECD正式描述(TG 442E),并包括皮肤致敏的计算预测。
- 皮肤致敏的计算预测由Derek Nexus或OECD QSAR Toolbox提供
经典ITS DA针对危害和效力鉴定进行了评估,使用的精选数据集包括最多168种具有LLNA参考数据的化学品和最多66种具有人体参考数据的化学品,DA的性能包含替代信息源的数据集分别针对72-159种和37-64种同时具有LLNA数据和人类参考数据的物质进行了评估。与LLNA和人类参考数据相比,在危害鉴定方面,ITS DA 的平衡准确率范围为78-88%
与人类参考数据相比,10种ITS排列组合中有8种(80%)的准确率与LLNA(60%)相当或更优。然而,有两种ITS排列组合(表1.3)的准确率低于LLNA,原因是将若干1A类致敏物错误地低预测为1B类致敏物。这种低预测可归因于多种因素,包括在基于人类数据的亚分类中,预测的致敏剂量接近GHS 1A和GHS 1B亚分类之间的阈值(即所谓的GHS 1A-类)。有关该分类来源的更多信息,请参阅《OECD指南497皮肤致敏定义方法支持文件》
3.1 过敏强度预测流程
ITS DIP 使用分配给KE3和KE1试验定量结果的评分,以及来自计算机模拟工具的评分,将化学物区分为UN GHS类别1A(强致敏物)、类别1B(其他致敏物)或未分类(非致敏物)
DIP 从 ITS 最初发表版本(6-7)进行了修订,将1A致敏物的截断值从7分改为6分,以优化DA检测强致敏物的能力,并将 ITS 的适用性扩展到无法生成计算机模拟预测的化学物。DIP 与已发表版本的另一处修改在于其最初应用于ECETOC分类,而此处应用于UN GHS亚分类
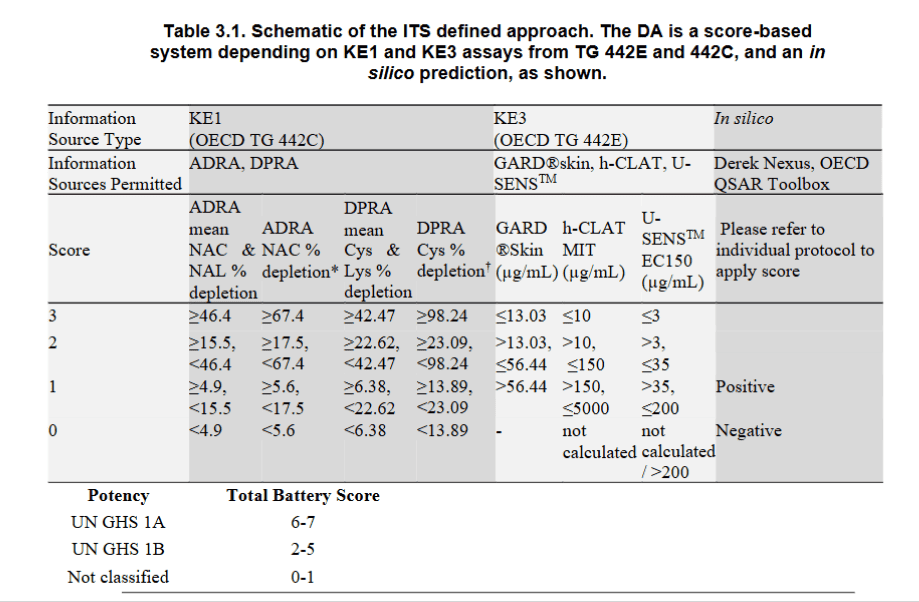
- KE1和KE3试验的定量结果按表3.1所示分别转换为0至3的评分
- 对于计算机模拟预测,阳性结果赋予1分;阴性结果赋予0分
- 通过将各单项评分相加,得出0至7的总评分,用于预测致敏潜力(危害鉴定;UN GHS Cat. 1与UN GHS NC对比)和效力(UN GHS Cat. 1A、Cat. 1B和NC)。鉴定皮肤致敏物(UN GHS Cat. 1)的阳性标准设定为总评分大于或等于2。根据更新的DIP,总评分划分为三个等级:6-7分定义为强(UN GHS Cat. 1A)致敏物;2-5分定义为中度/弱(UN GHS Cat. 1B)致敏物;0分或1分定义为未分类(即非致敏物)
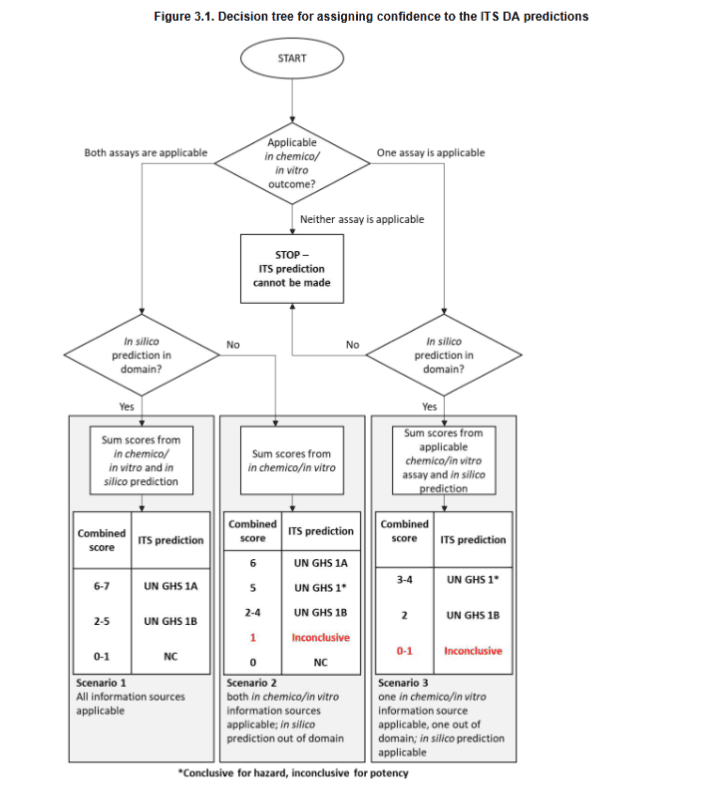
ITS DA预测的置信度水平根据DA总评分和各信息源的适用域进行分配,如图3.1流程图所示。关于是否可以使用所有信息要素的第一个决策取决于化学法和体外方法的局限性(见TG 442C和TG 442E),以及计算机模拟预测的适用域, 部分信息源(即仅两项化学法/体外结果,或一项化学法/体外结果加一项计算机模拟预测)可用于获得DA预测.
- DPRA和h-CLAT中只有一个实验可以被使用,另一个实验不在适用范围内称为 one assay applicable
- 三个信息源全部可以适用称为both assays in applicable
- In silico prediction in domain,主要是适用域内,这个化学物质是否落在该 in silico模型的applicability domain 适用域内
高置信度的DA预测在危害鉴定和效力方面被视为结论性预测。低置信度的DA预测在危害鉴定和/或效力方面被视为非结论性预测。这些”非结论性”预测仍可在证据权重方法中和/或在IATA框架内与其他信息源一并考虑
3.2 ITS DA准确率
ITS DA的预测能力基于LLNA数据进行报告,
| 评价指标 (Performance Metric) | 结果数据 (Results) |
|---|---|
| 准确率 (Accuracy) | 86 - 93% |
| 敏感性 (Sensitivity) | 91 - 94% |
| 特异性 (Specificity) | 65 - 82% |
| 均衡准确率 (Balanced Accuracy) | 78 - 88% |
由于参考数据存在数据不平衡(样本分布不均)的特性,特异性指标的评估(基于11至30种LLNA阴性化学物质)比敏感性指标的评估(基于111至129种LLNA阳性化学物质)具有更大的不确定性
ITS DA 与基于 LLNA 的参考数据对比:基于联合国 GHS 1A/1B 亚分类的统计数据
| 评价指标 (Performance Metric) | 结果数据 (Results) |
|---|---|
| 正确分类率 (Correct classification) | 66 - 80% |
| 低估率 (Underpredicted) | 13 - 18% |
| 高估率 (Overpredicted) | 4 - 17% |
该亚分类性能评估基于 N = 72-141 的样本量. 高估(Overprediction)是指化学物质被错误地分类为具有更强的致敏效力;例如,将非致敏物(NC)预测为 1A/1B 类致敏物,或将 1B 类致敏物预测为 1A 类致敏物; 低估(Underprediction)是指化学物质被错误地分类为具有更弱的致敏效力;例如,将 1A 类致敏物预测为 1B 类或非致敏物(NC),或将 1B 类致敏物预测为非致敏物(NC)
ITS DA与human-base 参考数据
| 评价指标 (Performance Metric) | 结果数据 (Results) |
|---|---|
| 准确率 (Accuracy) | 83 - 91% |
| 敏感性 (Sensitivity) | 87 - 96% |
| 特异性 (Specificity) | 44 - 57% |
| 均衡准确率 (Balanced Accuracy) | 67 - 76% |
ITS DA 与基于人类参考数据相比的效力分类性能,基于联合国 GHS 1A/1B 亚分类
| Performance Metric | Results |
|---|---|
| Correct classification (%) | 54 - 75 |
| Underpredicted (%) | 13 - 31 |
| Overpredicted (%) | 13 - 18 |
3.3 能力验证
ITS 定义方法(DA)依赖于一套简单的、基于规则的数据解释程序,无需引入专家判断。针对“化学物个体测试(in chemico)”和“体外(in vitro)”信息源(即关键事件 KE1 和 KE3)的能力验证化学品,已在相关指南(TG 442C 和 442E)中作出明确规定 (2, 3)。至于“计算机模拟(in silico)”信息源的具体操作方案,则包含在本指南的附录 I 和附录 II 中。
只要各个独立信息源证明了其能力,即可视为该定义方法(DA)具备了相应的能力
4. 用于推导定量起始点的定义方法
在 OECD 的测试指南体系中,通常会有一个主指南(Guideline, GL)和一个支持性文件(Supporting document)。主指南主要规定具体的测试步骤和规则,而支持性文件则包含了更详尽的背景资料、数据验证过程、性能特征等补充内容
4.1 用于推导起始点的 SARA-ICE 定义方法
SARA-ICE 的全称是 Skin Allergy Risk Assessment – Integrated Chemical Environment。它是由 NICEATM 与联合利华(Unilever)合作开发的一种贝叶斯统计模型
在 OECD 497 测试指南中,许多现有的“定义方法(DAs)”只能对化学品进行定性的危害分类(例如:是否致敏、GHS 分类是 1A 还是 1B)。而 SARA-ICE 的最大突破在于,它能够推导出定量的“起始点(Point of Departure, PoD)”,专门用于定量风险评估
该模型通过整合多种体外(in vitro)和体内(in vivo)测试数据,估算出一个与人体相关的皮肤致敏效力指标——ED01
- ED01 的含义:在人体预测性斑贴试验(HPPT)中,导致 1% 的人群发生皮肤致敏反应的概率所需的皮肤剂量(μg·cm⁻²)
- 这个 ED01 值就可以直接作为定量风险评估中的“起始点(PoD)”,并且模型还能明确量化其中的不确定性
- 因为科学测试存在不确定性,所以模型给出的 ED01 不是一个绝对的死数字,而是一个概率分布(可以想象成一条曲线,表示不同剂量下过敏的可能性)
- 只取 ED01 概率分布中,小于 60,000 µg/cm² 的那部分数据,然后算出它们的几何均值(一种平均数算法)
SARA-ICE DA基于AOP中KEs 1-4的试验方法数据。SARA-ICE DA基于先前发表的SARA模型,该模型最初包含81种化学物的数据库,随后扩展至434种化学物,利用了整合化学环境,AOP中的有害结局。SARA-ICE DA基于先前发表的SARA模型构建,该模型最初包含81种化学物质,随后扩展至434种化学物质,利用了综合化学环境(ICE,https://ice.ntp.niehs.nih.gov/)中包含的化学物质。
模型强烈建议使用体外或化学法数据(如 DPRA, KeratinoSens 等),并且要求至少有两个不同关键事件(KEs)的数据来保证预测的可靠性
限制动物测试:虽然模型兼容以前做过的动物实验数据(LLNA/HPPT),但严禁为了跑这个模型而专门去新做动物实验。这完全符合目前国际上“减少或替代动物实验(NAMs)”的毒理学发展趋势
对 SARA-ICE 定义方法(DA)的评估,首先采用了后验预测检验(posterior predictive checks),这也是针对任何贝叶斯统计模型所推荐的检验方法
- Posterior predictive checks(后验预测检验):这是贝叶斯统计学中用来验证模型好坏的一种标准操作。通俗来说,就是用模型已经算出来的结果(后验分布)去反向模拟生成一批新数据,然后看看这批模拟数据和现实中观察到的真实数据是否吻合。如果吻合,就说明这个模型建得靠谱
- 潜变量检验
通俗的来讲,SARA-ICE 模型先通过严格的统计学考试,证明了自己能真正从数据中学习,且能准确抓取关键信息;然后,它把过去几百种化学物质的经验浓缩成一套“通用法则”,以后遇到任何全新的化学物质,它都能用这套法则快速、准确地算出致敏风险
4.1.1 数据处理过程
SARA-ICE 定义方法(DA)使用贝叶斯统计模型来估算 ED01。起始点(PoD)的计算方法是:以 ED01 分布小于 60,000 µg/cm² 为条件,求该分布的几何均值。“该模型可以在没有任何特定化学物质输入数据的情况下运行,在这种情况下,得出的 ED01 估计值将直接取自先验分布(prior distribution)。然而,如果使用特定化学物质的数据来辅助估算,对于任何典型的输入,返回的 ED01 估计值的不确定性(方差)都会比先验分布有所降低。这种不确定性降低的程度取决于多个因素,包括输入数据的类型、数量以及各输入数据之间的一致性。为了确保实现显著的不确定性降低,应在用于运行模型的输入模板中,至少输入该化合物的 2 种测试方法的数据,且这 2 种方法必须涵盖 OECD TG 442C、442D 或 442E 指南中规定的 2 个不同的关键事件(KEs)
纯靠“经验”(无输入数据):如果你什么测试数据都不给,模型只能依靠之前 434 种化学物质总结出的“通用解题手册”(先验分布)来盲猜。这时候的预测结果不确定性最大
加入“线索”(有输入数据):一旦你输入了该化学物质的测试数据,模型就会把“通用经验”和“实际线索”结合起来。这时候得出的结果,其不确定性(方差)一定会比纯靠经验时更小
线索越多、越一致,结果越准:不确定性降低的幅度,取决于你给的线索类型、数量,以及这些线索之间是不是互相印证(concordance)
为了保证预测结果足够靠谱(不确定性得到实质性降低),OECD 指南规定了一个硬性门槛:必须至少输入 2 种不同关键事件(KEs)的测试数据(比如同时提供 DPRA 和 KeratinoSens 的数据)。只有满足这个最低配置,模型算出来的 PoD 才具有实际的监管参考价值
| Test Methods (测试方法) | Test Guideline (测试指南) | Key Event (关键事件) | Data Input (数据输入) |
|---|---|---|---|
| DPRA | TG 442C | 1 | Percent depletion (Cys and Lys) |
| kDPRA | TG 442C | 1 | log kmax (units M⁻¹ s⁻¹) |
| KeratinoSens | TG 442D | 2 | EC1.5 and IC50 (µM) |
| h-CLAT | TG 442E | 3 | EC200 (CD54), EC150 (CD85), CV75 (µg mL⁻¹) |
| U-SENS | TG 442E | 3 | EC150 and CV70 (µg mL⁻¹) |
| LLNA | TG 429, TG 442A, TG 442B | 4 | EC3 (percent) |
| HPPT | N/A | AO* | Dermal dose (µg cm⁻²), N test subjects, N subjects |
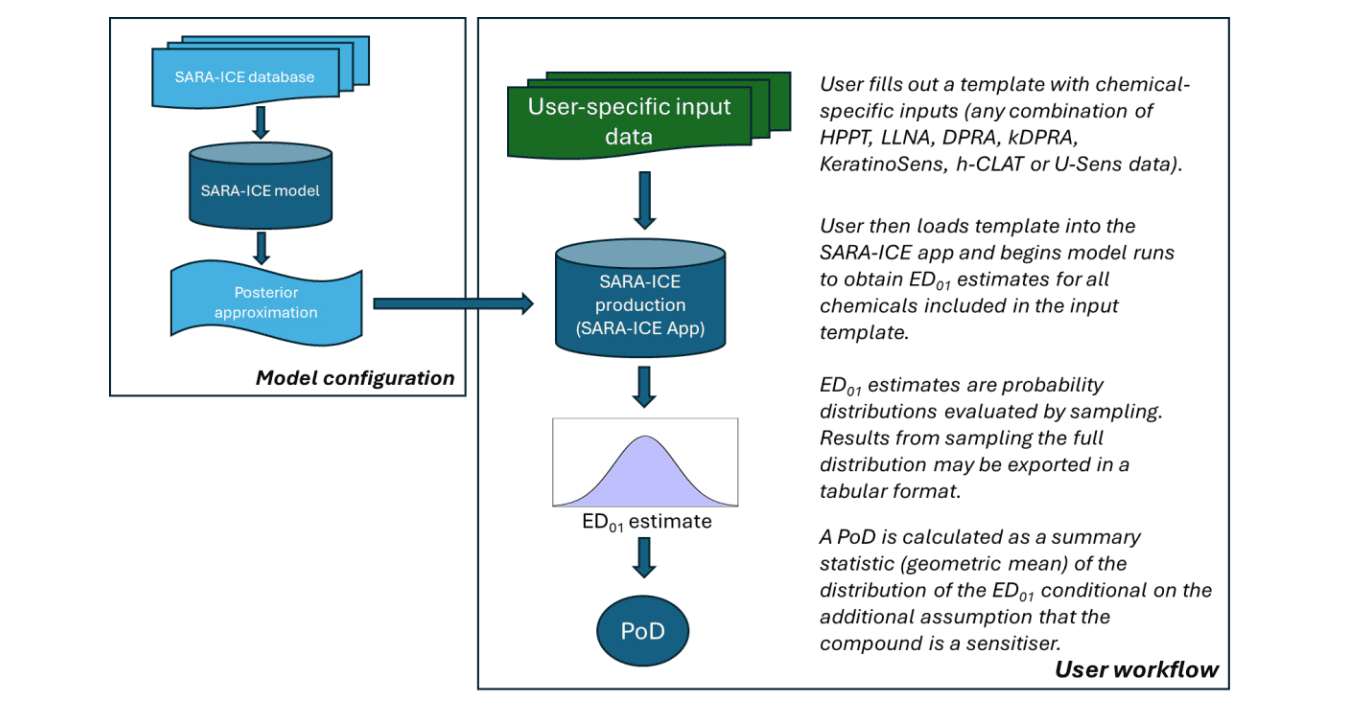
该模型将 ED01 估算为一个概率分布,通常以 90% 可信区间(即该分布的第 5 百分位数至第 95 百分位数之间的区间)来进行总结。该分布的方差是估算不确定性的一种衡量指标,其区间宽度取决于所提供的输入数据,例如输入数据的数量、类型以及各输入数据之间的一致性
为了定义用于皮肤致敏定量风险评估的起始点(PoD),该分布会在 60,000 µg/cm² 处进行截断(Truncated),因为这是标准人体重复损伤性斑贴试验(HRIPT)中可能的最大剂量。随后,计算该分布的几何均值作为起始点(PoD),以此作为该分布的汇总统计量
4.1.2 预测模型及其信息源的描述与局限性
各项化学法(in chemico)、体外(in vitro)和体内(in vivo)信息均使用现行的 OECD 测试指南(OECD TG 429、442A、442B、442C、442D、442E [4-10])及其中详述的方案生成。对于 kDPRA 和 KeratinoSens 试验,通常报告的浓度单位为摩尔浓度。如果将这些数据作为输入,模型还要求提供该化学物质的分子量,以便将其转换为质量浓度。请注意,SARA-ICE 模型可以接受现有的 LLNA 数据和 HPPT 数据作为输入;但是,不应为此生成新的体内(in vivo)数据
直接肽反应试验(DPRA;OECD TG 442C;关键事件 1):皮肤致敏剂通常具有亲电性,能与蛋白质的亲核部分发生反应。DPRA 通过测量含有半胱氨酸或赖氨酸残基的两种肽由于共价结合而产生的消耗量来进行评估。如果受试化学物质导致含半胱氨酸和赖氨酸肽的平均消耗量超过 6.38%(或在发生共洗脱的情况下,仅含半胱氨酸肽的消耗量超过 13.89%),则被视为阳性。SARA-ICE 定义方法(DA)不使用此分类规则。取而代之的是,输入 SARA-ICE 的是这两种肽的消耗百分比。随后,SARA-ICE 定义方法(DA)会确定这两种肽中的最大消耗量。低于 1% 的消耗量将被解释为 < 1%,而高于 99% 的消耗量将被解释为 > 99%。需要注意的是,尽管 DPRA 重量法尚未被专门针对 SARA-ICE DA 的使用进行评估,但鉴于在 OECD TG 442C 下开展的 DPRA 重量法评估发现这两种方法是等效的,因此预期其提供的数据在可接受的范围内,可作为输入 SARA-ICE 的数据
动力学直接肽反应试验(kDPRA;OECD TG 442C;关键事件 1):kDPRA 旨在以时间和浓度依赖的方式量化受试化学物质的反应性。该试验测定半胱氨酸肽(DPRA 中使用的肽)的消耗速率。动力学速率常数被计算并报告为 log Kmax 值,其中 Kmax 的单位为 M⁻¹ s⁻¹。kDPRA 用于区分联合国全球化学品统一分类和标签制度(UN GHS)亚类别 1A 与未归为亚类别 1A 的物质。对于 SARA-ICE,log Kmax 会被转换为 g L⁻¹ s⁻¹ 的单位并乘以 -1(这样一来,效力越高的化学物质对应的数值就越低)。该转换由模型自动处理,前提是已指定该化学物质的分子量。如果反应速率过慢而无法测量,则输入值应为 < X,其中 X 为该试验的检测限。出于训练目的,该检测限被假定为 -3.5 M⁻¹ s⁻¹;因此,对于在 kDPRA 中表现出可忽略反应性的化学物质,输入值应为 < -3.5。
KeratinoSens 试验(体外皮肤致敏:ARE-Nrf2 荧光素酶测试法;OECD TG 442D;关键事件 2 ):含有报告基因构建体的角质形成细胞通过 Nrf2-Keap1 通路对可能的致敏剂产生反应。与溶剂对照组相比,如果受试化学物质在细胞活力 > 70% 的条件下,导致荧光素酶诱导超过 1.5 倍,则被视为阳性。SARA-ICE 模型的输入值为 EC1.5 (µM) 和 IC50 (µM)。在提供分子量的前提下,模板会将这些值转换为 µg mL⁻¹ 单位。模型还接受 > X 或 < X 形式的输入,其中 X 为试验中的某个测试浓度。例如,在输入阴性测试结果(无 EC1.5 定义)时就需要这样处理。如果测试为阴性,即在任何测试浓度下均未观察到荧光素酶诱导,则模型的输入值应为 > X,其中 X 为最高测试浓度。同样,如果在所有测试浓度下均观察到 > 1.5 倍的诱导(即在所有测试浓度下测试均呈阳性),则 SARA-ICE 的输入值应提供为 < X,其中 X 为最低测试浓度。
U-SENS 试验(OECD TG 442E;关键事件 3 ):抗原呈递细胞的激活以 CD86 的上调为特征。如果与溶剂对照组相比,在细胞活力 > 70% 的条件下 CD86 的诱导超过 1.5 倍,则 U-SENS 试验被视为阳性。SARA-ICE 模型的输入值为 CD86 EC150 (µg mL⁻¹) 和 CV70 (µg mL⁻¹)。如果测试为阴性,模型的输入值应为 > X,其中 X 为最高测试浓度。如果在所有测试浓度下 CD86 的诱导均超过 1.5 倍,则输入值应为 < X,其中 X 为最低测试浓度。
局部淋巴结试验(LLNA;OECD TG 429、442A、442B;关键事件 4 ):皮肤致敏的诱导阶段(KE4)的特征是暴露部位引流淋巴结中的淋巴细胞增殖,且该增殖与物质的剂量和效力成正比。LLNA 测量小鼠耳部接触受试物质后,其淋巴结增殖相对于溶剂对照组的比例。每个处理组的平均增殖与溶剂对照组的比值即为刺激指数(SI)。SI ≥ 3 被认为表明具有皮肤致敏性。SARA-ICE 模板的输入值为以百分比表示的 EC3。模型会将其转换为 µg cm⁻²。对于阴性测试结果,模型也可接受 > X 形式的输入,其中 X 为最高测试浓度。或者,如果所有测试浓度均导致 SI 大于 3,建议输入 SARA-ICE 的值为 < X,其中 X 为最低测试浓度。这也允许将单剂量 LLNA 研究输入 SARA-ICE DA。如果单剂量 LLNA 在浓度 X 下运行且 SI < 3,则输入 SARA-ICE 的值为 > X。相反,如果 SI > 3,研究结果可作为 < X 输入。仅建议将现有的 LLNA 数据用于 SARA-ICE 模型。
人体预测斑贴试验(HPPT):HPPT 方法包括人最大化试验(HMT)和人体重复损伤性斑贴试验(HRIPT)。这两种测试方法均通过让受试者暴露于特定皮表剂量的(潜在)过敏原后,来量化其经验致敏率。HMT 包含使用刺激物进行预处理,且其测试样本量通常小于 HRIPT。SARA-ICE DA 要求的 HPPT 输入数据包括:以 µg cm⁻² 表示的皮表剂量、测试受试者总数,以及在激发阶段后发生致敏的受试者总数。
目前各项测试方法的局限性(例如溶解度方面的限制)已在相应的测试指南及其引用的验证研究中进行了描述。在训练 SARA-ICE DA 之前,未对试验数据进行任何过滤,因此该 DA 提供的不确定性指标应能反映这些局限性。然而,在选择输入数据时仍需保持谨慎,因为仍可能出现偏差(例如,当对需要通过代谢激活才能增强致敏潜力的化学物质使用 DPRA 输入数据时)。出于监管目的运行该 DA 时,应仅使用有效的试验结果,即处于各输入试验适用域(applicability domain)内的结果。在使用数据前,应对其进行数据质量评估,这包括对人体数据的评估
4.1.3 SARA-ICE DA预测的可信度
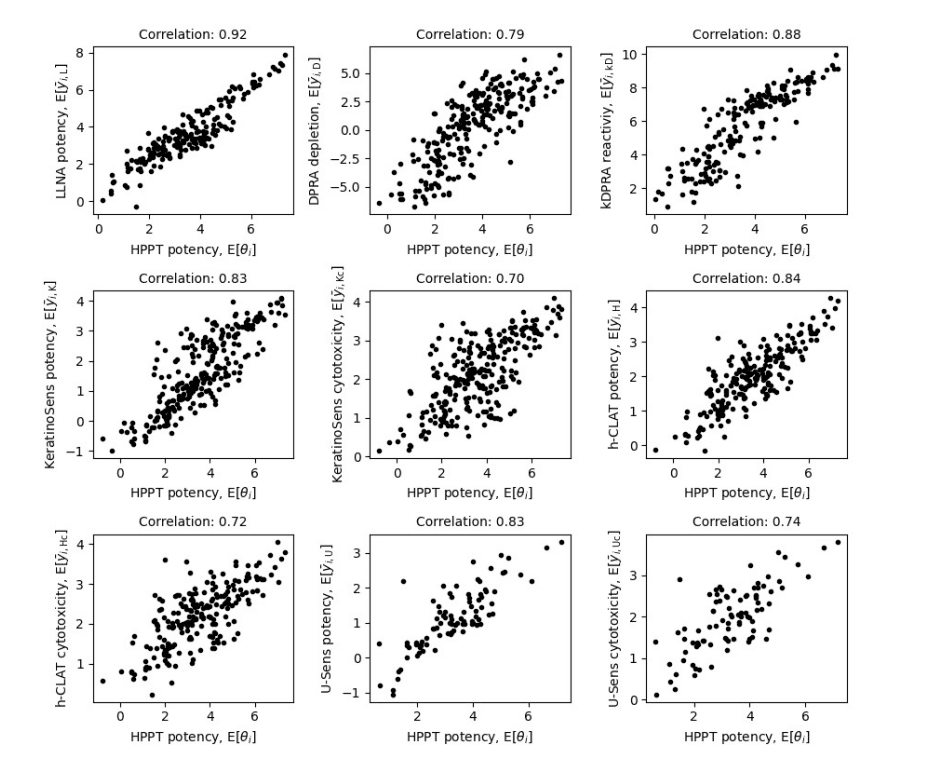
SARA-ICE DA 建立在贝叶斯统计模型之上,因此能够提供带有数值精度衡量标准的效力(potency)估计值。所提供的分布代表了 ED01 值的范围,这些值既与用户指定的输入数据一致,也与模型相吻合——其中,模型是对 434 种化学物质训练集中 ED01 估计值与试验数据之间关联性的表征。有关 SARA-ICE 数据库的更多信息,请参阅附录 2 中的技术规范。
为确保 SARA-ICE 模型的表现符合预期,已进行了一系列基础模型检验。后验预测检验表明,各参数的边际后验分布并未集中在先验分布的极端尾部,这说明所选先验对后验估计仅具有微弱的信息量(weakly informative)。因此,即使放宽先验的选择,模型参数的估计值也不太可能发生改变。此外,还完成了进一步的检验,以确认模型中关于预测变量(predictors)与响应变量之间存在非零斜率的线性关系这一假设
SARA-ICE 可推导出用于风险评估的起始点(PoD)。该模型估算在符合 HPPT(人体预测斑贴试验)条件的人群中,有 1% 可能发生皮肤致敏的剂量(ED01),并以带有相关置信区间的分布形式进行报告。在进行 PoD 估算时,ED01 分布的上限被设定为 60,000 µg cm⁻² 的阈值。这一阈值对应于 GHS 分类中的‘未分类(NC)’界限,并隐含了一个假设:即正在考虑基于 PoD 进行风险评估的化学物质是一种致敏剂。因此,起始点(PoD)被定义为:以 ED01 小于 60,000 µg cm⁻² 为条件,该 ED01 分布的几何均值
使用 DASS 评估集中报告的
- 化学法(in chemico)和体外(in vitro)数据(包括 DPRA、KeratinoSens 和 h-CLAT 的单次测试输入),以及
- b)来自 Natsch 等人(2022年)的单一 kDPRA 数据,为评估集中的所有 196 种化学物质计算了起始点(PoD)。
需要注意的是,DASS 评估集中 95%(187/196)的化学物质都包含在 SARA-ICE 数据库中。然而,大多数化学物质用于训练和评估的数据是不同的。在训练阶段,一种化学物质可能同时拥有体内(in vivo)和体外(in vitro)数据,且每种数据类型可能包含多项研究。而在评估阶段,输入数据被严格限制为单次 DPRA、单次 KeratinoSens、单次 h-CLAT 以及单次 kDPRA 研究(若可获得)。因此,在训练期间获得的 ED01 估计值可能与在评估期间获得的估计值存在显著差异。
4.2 用于推导皮肤致敏起始点(PoD)的’基于回归’的定义方法
基于回归的定义方法(DA)建立在多元线性回归模型之上。在输入数据方面,该方法使用了针对皮肤致敏不良反应路径(AOP)的关键事件 1(KE1)、2(KE2)和 3(KE3)的体外(in vitro)和化学法(in chemico)试验产生的定量数据(包括剂量-反应数据和动力学数据)。不同的模型分别基于以下两类数据进行训练: - (i) 局部淋巴结试验(LLNA)得出的 EC3 值 ; - (ii) 基于人类 DSA04 数据、NOEL 值和 LLNA EC3 值推导出的证据权重(WoE)效力值(PV)[3]。
这些独立的回归模型在 DA 中进行整合,以提供一个有限的起始点(PoD),该 PoD 可应用于皮肤致敏的定量风险评估。该 PoD 既可以表示为以 25 mg/cm² 的剂量涂抹于皮肤上的溶剂中的百分比浓度(%)(类似于 LLNA 中的表示方式),也可以表示为以 µg/cm² 为单位的单位面积剂量。这两种指标之间的换算系数为固定值 250。
- 底层算法(多元线性回归)
与 SARA-ICE 使用的贝叶斯模型不同,这种基于回归的 DA 使用的是“多元线性回归模型”。它将多个体外测试的连续变量(如 DPRA 的消耗量、KeratinoSens 的 EC1.5 等)作为自变量,去预测一个因变量
- 双重训练目标(锚点)
为了让体外数据能够准确预测真实的致敏剂量,研究人员用两种“金标准”数据来训练模型
- 动物实验数据:LLNA 试验得出的 EC3 值
- 人体与动物综合数据:基于人类测试(DSA04、NOEL)和 LLNA 数据综合推导出的“证据权重效力值(PV)”
- 最终输出(PoD 的两种单位及换算)
模型最终会给出一个具体的起始点(PoD),并且提供了两种表达方式:
- 百分比浓度(%):模拟 LLNA 试验,假设涂抹剂量为 25 mg/cm² 时的浓度百分比
- 绝对剂量(µg/cm²):直接表示单位皮肤面积上的致敏剂量。
- 换算公式:这两者之间是简单的数学关系,换算系数固定为 250(即 25 mg/cm² = 25,000 µg/cm²,25,000 / 100 = 250)
这种方法就是把各种体外测试的数值放进一个“多元线性回归公式”里,通过动物和人体的真实数据作为标尺进行校准,最终算出一个具体的致敏剂量底线(PoD)。这个底线既可以用“百分比浓度”来表示,也可以用“每平方厘米微克数(µg/cm²)”来表示,两者之间可以通过乘以或除以 250 轻松换算。
附录1: 用于 2O3 DA 的、包含多次重复运行的单个化学/体外测试预测模型
2o3 DA中包含的每种测试方法都有不同的预测模型,可能需要多次运行(独立重复),具体取决于单次运行的结果。2o3 DA中进行预测时,使用了预测模型的适应版本来确定各次运行中的边界情况。2o3中包含的方法有:DPRA、ADRA、KeratinoSens(TM)、LuSens、EpiSensA、h-CLAT、U-SENS(TM)、IL-8 Luc试验和GARD(R)skin。LuSens、ADRA、EpiSensA、IL-8 Luc和U-SENS(TM)的边界规则(BR)推导方法可在已发表的文献中获取