Abstract
本文介绍 Paper2Agent,一个能够将研究论文转化为人工智能 (AI) 智能体的自动化框架。Paper2Agent 将被动的研究成果转化为主动系统,从而加速其应用和发现。传统的论文要求读者理解并应用论文中的代码、数据和方法,这阻碍了成果的传播和重用。Paper2Agent 通过将论文转化为 AI 智能体来解决这一难题。该智能体作为虚拟通讯作者,将论文的稿件、补充材料、数据集、代码和工作流程以主动的、智能体原生的知识形式呈现,而非静态文本。
它利用多个agents分析论文和代码库,构建模型上下文协议(MCP)服务器,然后生成并运行测试,以改进和增强MCP的鲁棒性。这些论文MCP可以连接到聊天agents(例如Claude Code),通过自然语言执行复杂的科学查询,同时调用论文中的工具和工作流程。
Paper2Agent 创建了一个利用 AlphaGenome来解释基因组变异的代理,以及基于 Scanpy和 TISSUE(具有空间单细胞不确定性估计的转录本插补)的Agent,以进行单细胞和空间转录组学分析。这里作者验证了这些智能体能够复现原始论文的结果,并执行新的用户查询。Paper2Agent 创建了多个Agent,它们协同工作,以确定银屑病致病基因的优先级。通过将静态论文转化为交互式 AI 智能体,Paper2Agent 引入了一种知识传播范式,并构建了一个 AI 合作科学家的协作生态系统。
Introduction
我们在常规读论文的过程中必须发现论文。解析论文内容,并手动操作来确定如何将其应用到自己工作中。读者可能需要找到相应的代码库,安装依赖项,配置环境,并解释正确的输入和输出。即使代码库维护良好,这个过程通常也不简单。
例如AlphaGenome提供了基因组规模的基础建模一个强大的框架,但是其设置和部署需要大量的技术专长,限制了原本可以从中受益的生物学家的使用。在代码中使用 AlphaGenome 包括安装环境、创建带有应用程序编程接口 (API) 密钥的客户端对象、构建诸如变异对象之类的输入以及选择所需的输出模式。
AlphaGenome是由谷歌旗下DeepMind公司开发的一款人工智能模型,主要用于解码基因组功能与预测基因变异的影响。
2026年1月29日作为封面文章发表于《自然》杂志。它能一次性处理长达100万个碱基对的DNA序列,并以单碱基分辨率同时预测基因表达、RNA剪接、染色质状态等多种分子特征,提升了对占基因组98%的非编码区域的解读能力。
作者指出Paper2Agent 通过将静态论文转化为活跃的 AI 代理,重新定义了研究成果的传播方式。每个代理都作为相应论文的交互式专家,能够演示、应用论文中的方法,并将其调整应用于新的项目。现代Agent理通常由大型语言模型(LLM)驱动,这些模型连接到外部工具或应用程序接口(API),并且可以根据反馈进行调整。AI Agent包括通用科学智能体和领域专业智能体在内的一些列最新系统以及科学文本自动生成代码的研究,都已经开始展示出来成为范式的潜力。
Paper2Agent 提供了一个自动化工作流程,用于将科学论文转换为Agent。其核心思想是将论文表示为 MCP 服务
转换过程识别论文的关键贡献,通过 MCP 服务器对其进行封装,并将服务器与基于 LLM 的代理连接起来,以实现自然语言查询和自主执行。用户可以通过提问、请求演示或将该方法应用于新数据来与论文进行互动。例如,将 Paper2Agent 应用于 AlphaGenome 会将其基因组基础模型公开为 MCP,这样用户就不必克隆存储库和配置依赖项,只需询问:“解释此变体对肌肉细胞染色质可及性的预期影响”。
Paper2Agent 可代理完整的科研成果,包括手稿、补充材料、代码、数据集、可执行示例和分析工作流程。在此框架下,论文成为可执行的研究成果,能够回答问题、复现分析结果、将方法应用于新数据,并与其他论文主体进行交互。这代表了一种新的科学交流模式,超越了静态传播,迈向互动协作。
Paper2Agent概述
Paper2Agent 是一个多智能体人工智能系统,它能够以最少的人工干预自动将研究论文转换为交互式人工智能体。通过该框架创建的论文智能体包括:
- 交互性强,易于使用。用户可以通过自然语言提示执行复杂的科学分析,无需任何编程专业知识。
- 可靠且可复现。Agent理使用的每个工具都使用示例数据集,对照参考代码库报告的结果和图表进行验证,然后锁定以确保可复现性,这种设计降低了“代码幻觉”的风险,即执行不准确的LLM生成的代码可能导致错误的科学结果。它还最大限度地减少了代码生成的随机性,进一步增强了可重复性。最后,每个工具都包含原始论文中的代码引用,以确保透明度和可追溯性。
Paper2Agent 基于此生态系统构建,包含两个组件:(1) Paper2MCP,用于从论文及其代码库中提取信息以构建远程 MCP 服务器;(2) 代理层,用于将每个 MCP 服务器封装为上下文提供程序,以实例化特定于论文的 AI 代理。
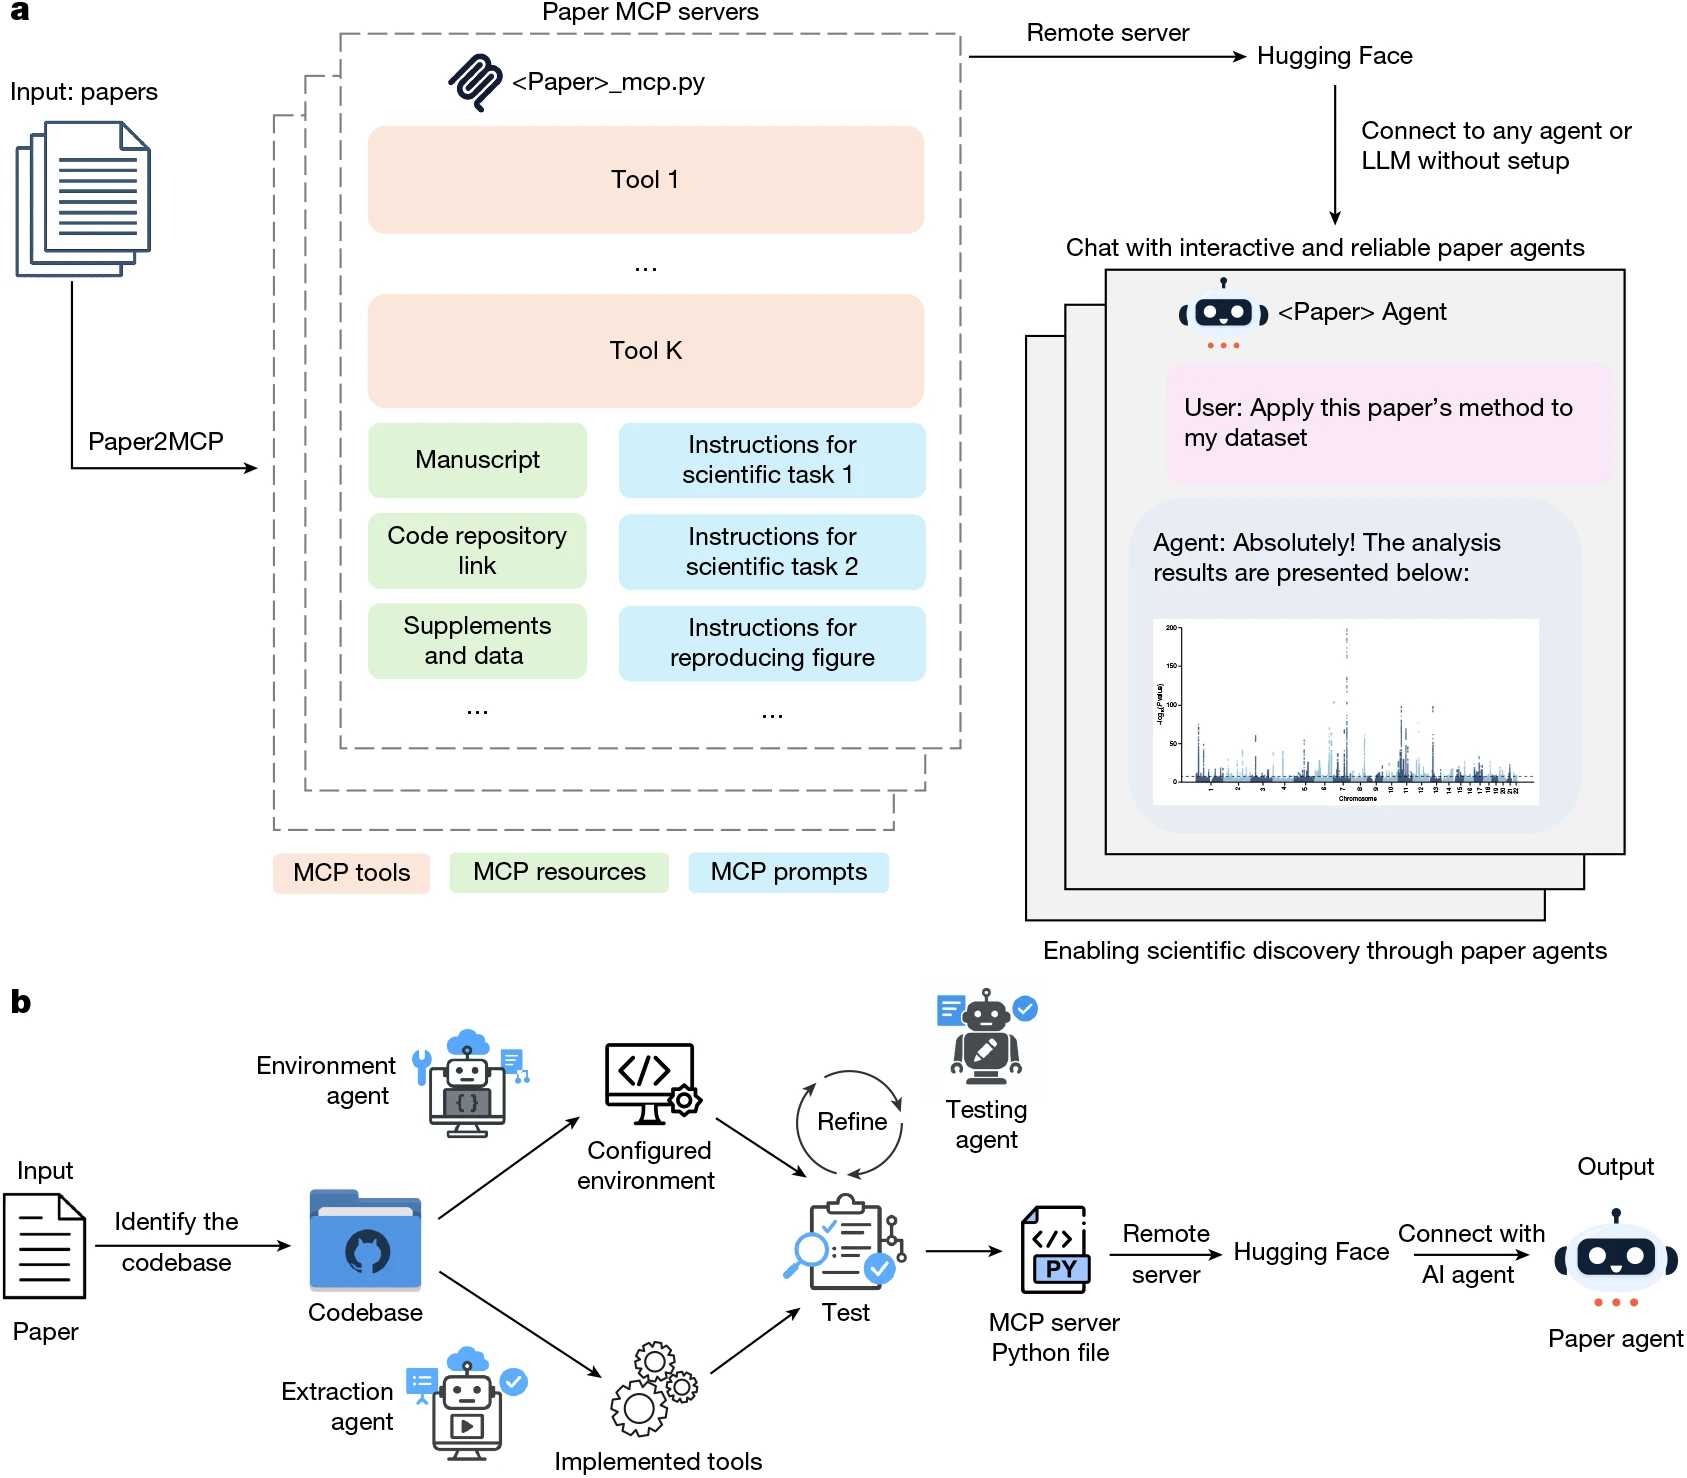
每个MCP Server包含三个核心成分:
MCP 工具是可执行函数,它概括了论文的方法论贡献。例如,AlphaGenome 的一个 MCP 工具以基因变异作为输入,生成其对基因表达、染色质可及性及其他模式影响的预测和可视化结果。这些工具配备了预配置的环境,可实现无缝执行
MCP资源库存储着静态资产,包括论文正文、相关代码库以及数据集、表格和图表等补充材料。例如,AlphaGenome MCP 资源包含用于训练模型的训练数据的链接。所有资源均以易于访问的标准化格式存储,以便人工智能代理能够高效地查询和集成。
MCP 提示包含简洁的指令,指导 AI 代理完成源自论文文本或代码库的复杂、多步骤科学工作流程。例如,Scanpy MCP 提示编码了单细胞数据预处理和聚类的步骤顺序,我们将在本文后续部分进行介绍。这些模板整合了各种工具和资源,以确保可重复、系统化的分析,同时降低了有效提示的门槛。
The paper MCP 可以远程托管在诸如 Hugging Face Spaces (https://huggingface.co/spaces) 之类的平台上,从而消除本地依赖问题。The Agent 该层将每个 Paper2MCP 服务器封装为上下文提供程序,创建paper-specific对话。任何兼容的 LLM 或代理都可以连接到这些服务器,以执行诸如可重复性检查、新数据分析或图形重新生成等任务。
Claude Code中调用两个专门的agent:环境代理,用于配置必要的软件环境;以及提取代理,用于将核心方法转换为已实现的工具。
   ↓
找到论文对应的代码库
   ↓
┌─────────────────────┐
│ Environment Agent   │ → 配置运行环境
│ Extraction Agent    │ → 把论文方法提取并实现成工具
└─────────────────────┘
   ↓
Testing Agent
   ↓
自动测试
├─ 文件是否正确生成?
├─ 数值结果是否在容差范围?
└─ 图片是否与参考结果一致?
   ↓
失败 → 修改代码/环境 → 重新测试
   ↓
通过
   ↓
打包成 MCP Python Server
   ↓
部署到远程服务器(如 Hugging Face)
   ↓
连接 Claude Code 等 AI Agent
   ↓
用户用自然语言调用论文的方法
Results
AlphaGenome agent for genomics
论文中第一个例子是 AlphaGenome Agent。AlphaGenome 是一种人工智能模型,旨在预测人类 DNA 序列中单核苷酸变异或突变对多种调控过程的影响。Paper2Agent 将 AlphaGenome 论文转换为交互式 AlphaGenome 智能体,从而实现基因组数据的自动解读。通过自然语言查询,用户可以利用该agent对疾病相关变异的致病基因进行优先级排序,阐明单个变异的调控影响,并为具有特定调控功能的合成 DNA 的设计提供信息。
Paper2Agent 在一台个人笔记本电脑上,仅用约 45 分钟就生成了 22 个 AlphaGenome MCP 工具,全部通过了自动验证,无需人工干预,成本仅为 14 美元,全面涵盖了其方法创新。这些 MCP 工具涵盖了功能分析中的单变量和批量变异评分、序列水平预测、组织本体探索以及一套全面的可视化套件。
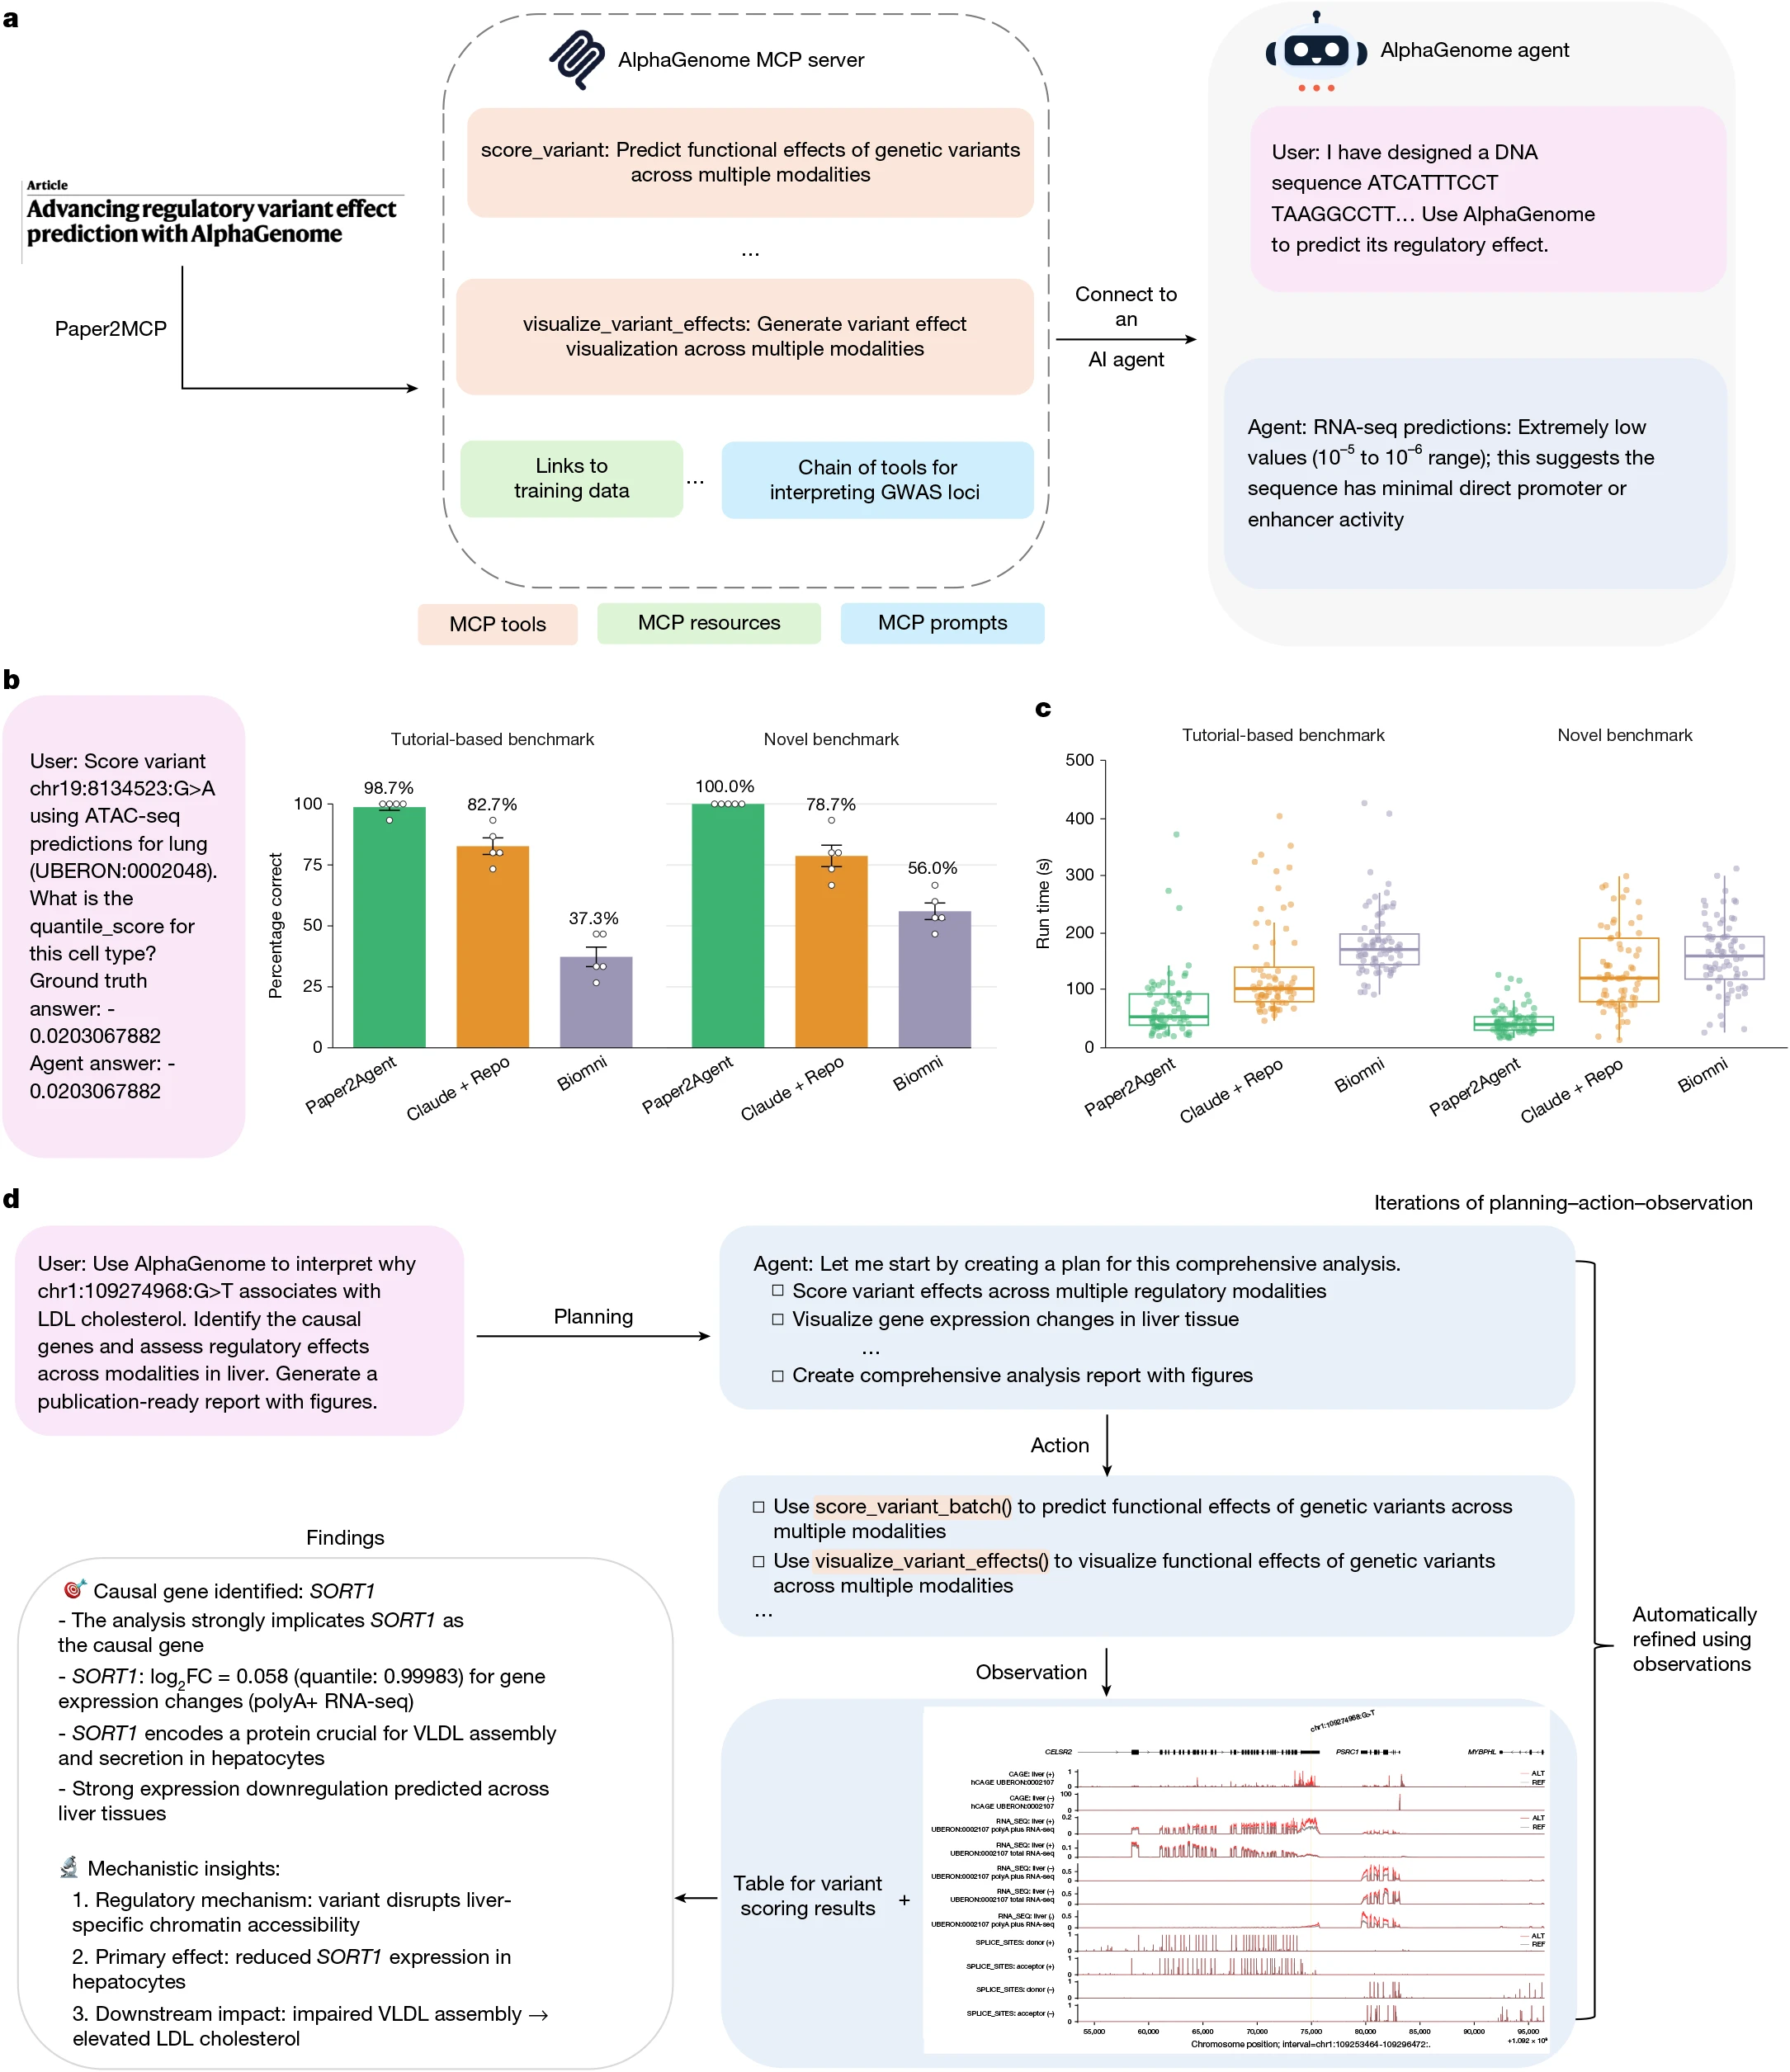
score_variant_effect()是MCP 工具能够预测多种模式下基因变异的功能后果,例如基因表达、剪接和染色质可及性,并适用于多种组织和细胞类型visualize_variant_effects()是生成特定模态的可视化结果,简化对调控效应的解释
给定一个输入的遗传变异,AlphaGenome Agent 可以调整变异周围的序列上下文长度,并切换不同的模式——例如 RNA 测序 (RNA-seq)、转座酶可及染色质测序 (ATAC-seq) 或染色质免疫沉淀测序 (ChIP-seq) 组蛋白轨道
Biomni 是一个通用型 Biomedical AI Agent(生物医学 AI Agent),由 Stanford 的团队开发。它的目标是让 AI 不只是“回答生物医学问题”,而是能够自己规划任务、检索知识、调用工具、写代码并执行分析。
| Claude + Repo | Biomni | Paper2Agent Agent | |
|---|---|---|---|
| 核心思路 | AI + 一个代码仓库 | AI + 生物医学工具生态 | 论文 → 专用工具 → AI |
| 知识来源 | Repository | Biomedical knowledge + tools | 某篇论文的方法 |
| 工具来源 | 自己从 repo 找 | Biomni 工具库 | Paper2Agent 自动提取 |
| 能否写代码 | ✅ | ✅ | Claude Code 可以 |
| 能否执行分析 | ✅ | ✅ | ✅ |
| 是否针对某篇论文 | ❌ | ❌ | ✅ |
| 是否可以组合多个工具 | ✅ | ✅ | ✅ MCP |
Biomni相当于给 AI 一个庞大的生物医学工具箱,让 AI 自己选择工具
              Benchmark
                  │
        ┌─────────┴─────────┐
        ↓                   ↓
 Tutorial-derived       Novel tasks
        ↓                   ↓
   已知 workflow        未见过的组合
        │                   │
        └─────────┬─────────┘
                  ↓
            Agent 回答
                  ↓
          与 ground truth 比较
最后,作者证明了 AlphaGenome 代理能够自动解释全基因组关联研究 (GWAS) 位点,并验证原始论文中的分析。该计划包括生成输入文件、对多种模态的变异进行评分、筛选与性状相关的组织结果、创建模态特定的可视化图以及编写解释报告
Scanpy agent for single-cell analysis
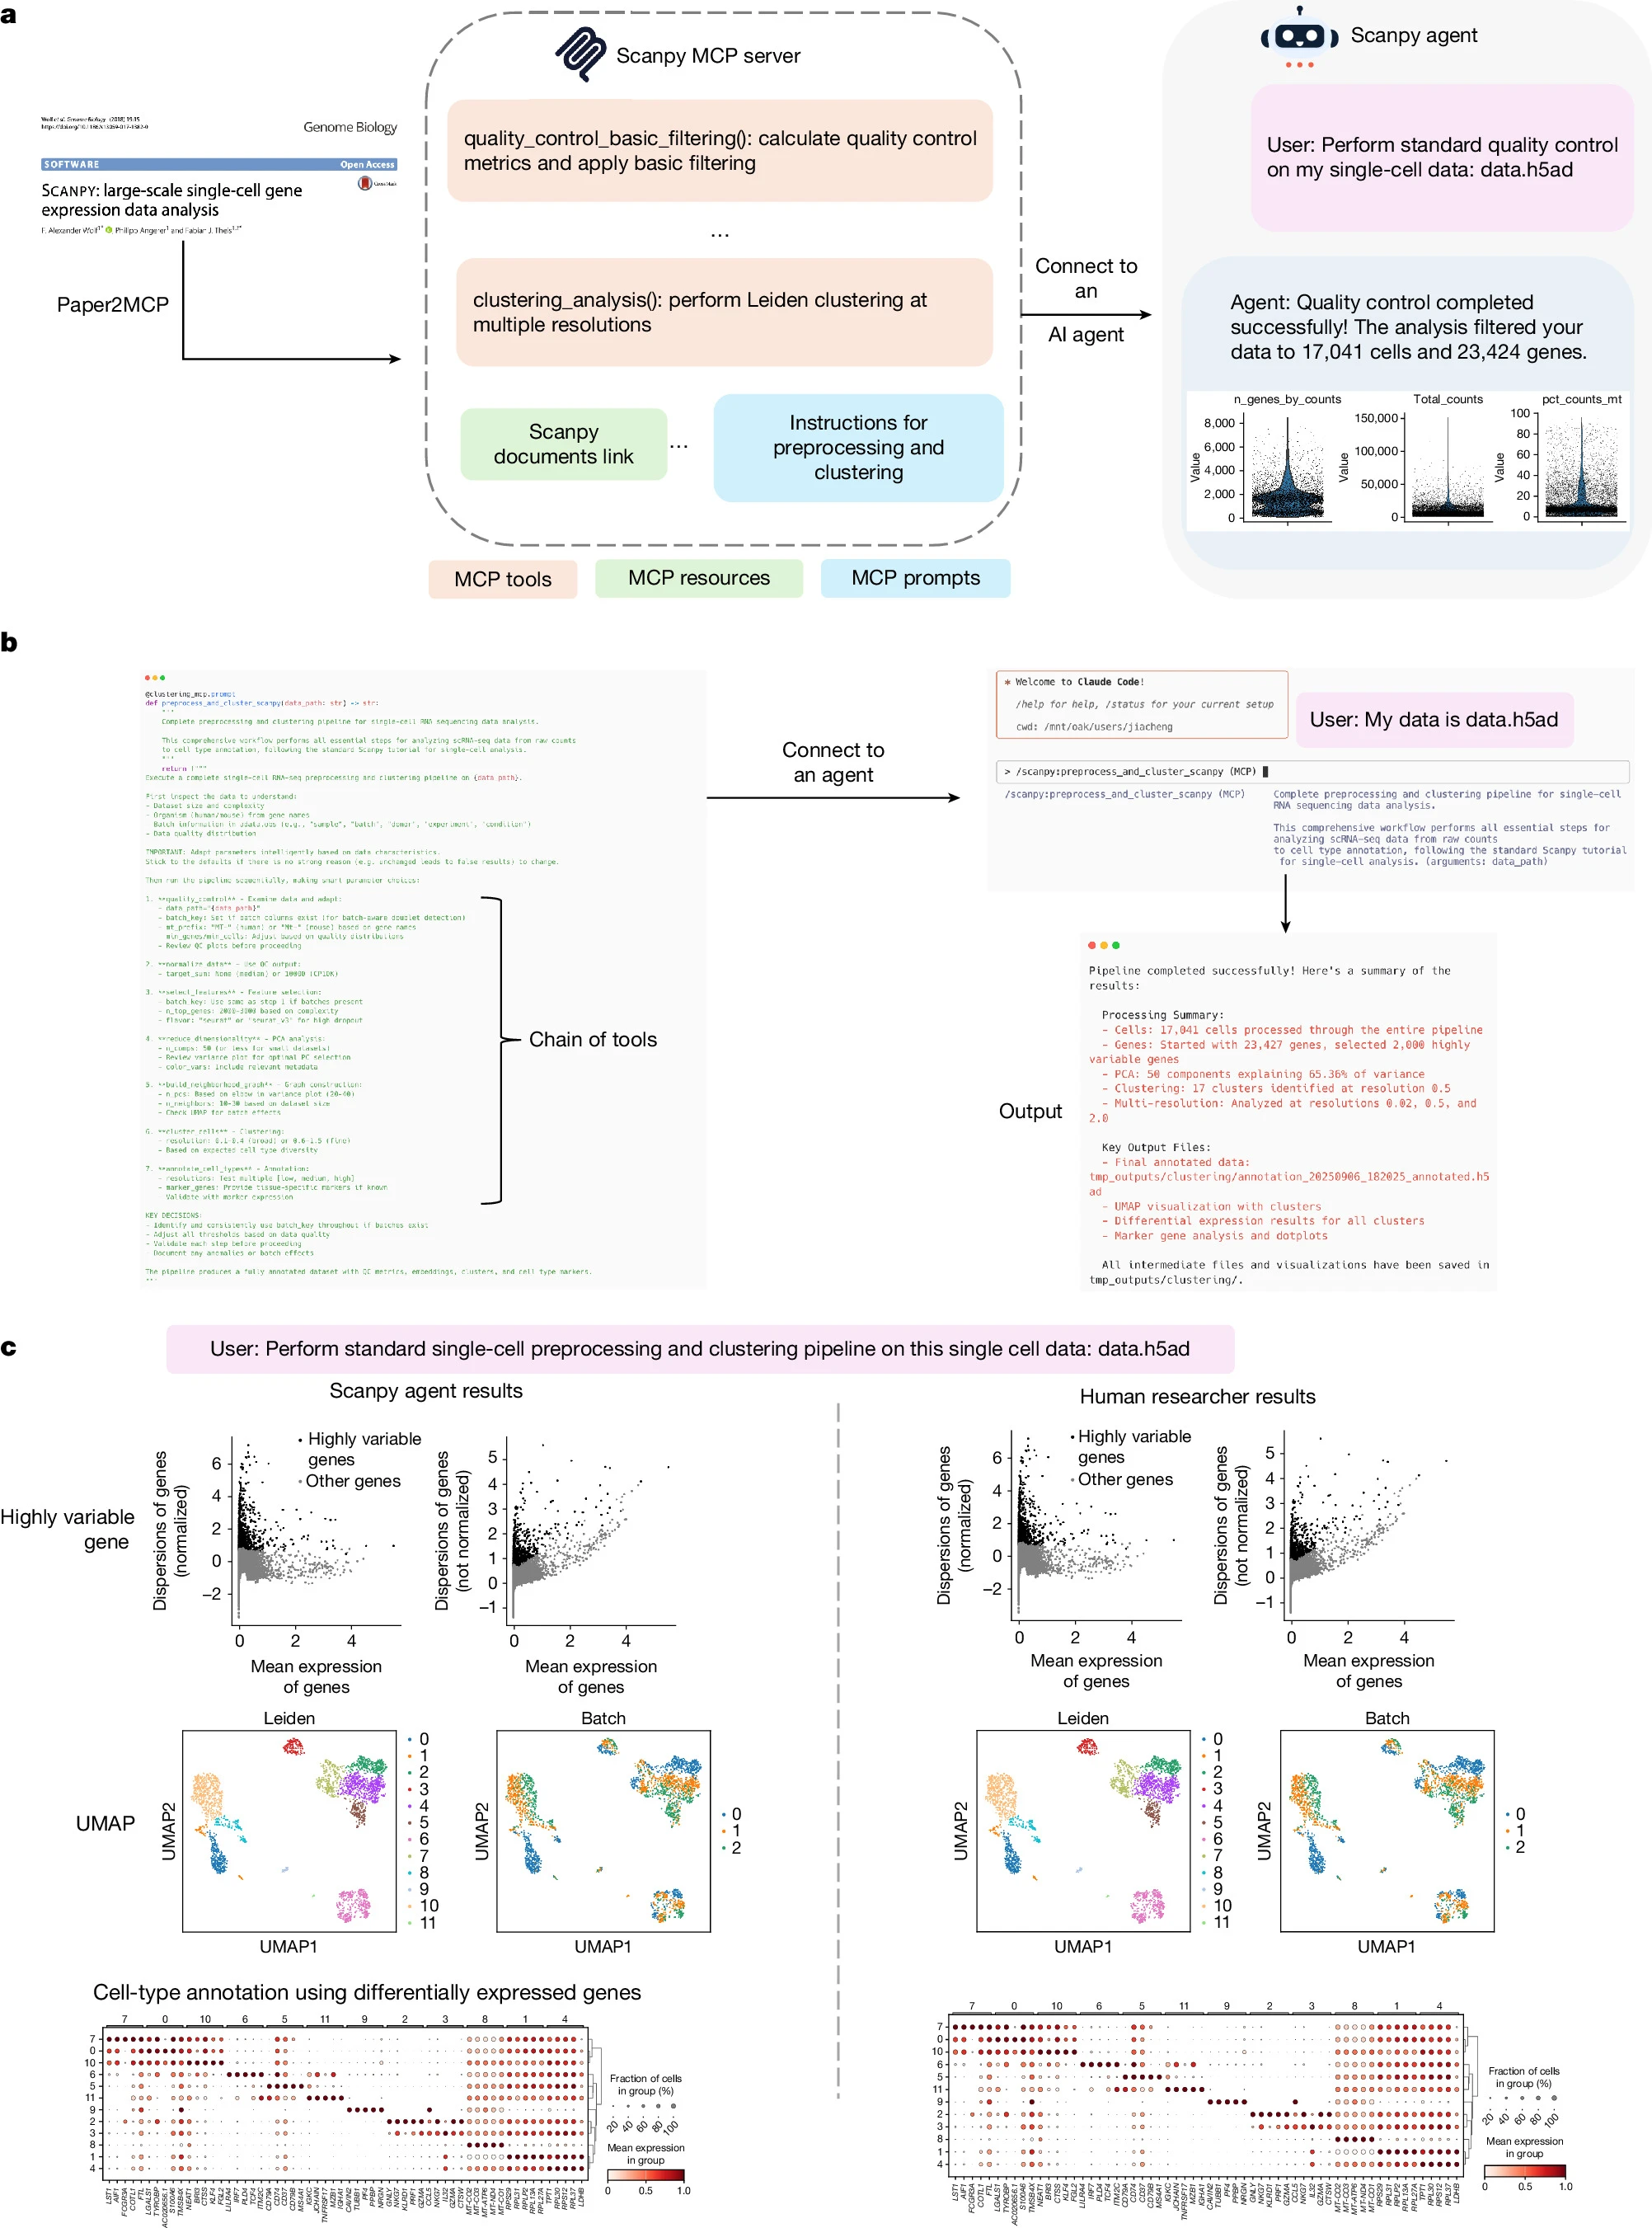
作者展示了Paper2Agent生成的Scanpy代理在单细胞数据分析中的应用。Scanpy 是一个广泛用于分析大规模单细胞转录组数据的软件包。重点关注 Scanpy 最常见的应用场景:单细胞数据的预处理和聚类。Paper2Agent 为此功能生成了七个工具,所有工具均通过了自动验证,在个人笔记本电脑上仅用约 45 分钟,成本为 13 美元。
quality_control()计算和可视化质量控制指标,筛选细胞和基因,以及检测双细胞
执行此类工作流程可能具有挑战性:人工智能Agent必须已经“知道”正确的操作顺序,或者用户必须提供精心设计的提示,明确指定顺序。MCP 提示提供了一种标准化的工作流程编码方式,确保工具按正确的顺序执行,并减轻用户手动指示代理的负担。
Paper2Agent 生成的 Scanpy MCP 提示编码了一个标准的预处理和聚类流程,包括质量控制、归一化、特征选择、降维、图构建、聚类和细胞类型标注,且顺序正确。
Large-scale evaluation of Paper2Agent
为了测试可扩展性,我们对三个不同方向的论文语料库进行了端到端处理,期间未进行任何人工清理、代码修改或干预:100 篇计算生物学论文、26 篇数据和发现导向型论文,以及 10 篇涵盖人工智能、统计学、计量经济学、博弈论和天体物理学等非生物学计算领域的论文。
在 100 篇计算生物学论文中,有 74 篇成功实现了智能化,产生了 599 个拟议工具,其中 593 个通过了自动验证。其余论文的主要失败模式是缺少可执行代码、缺少数据或模型工件、环境或依赖项故障以及不通用的脚本。
Paper2Agent 在 10 篇非生物学计算论文的 42 项基于执行的任务中,在 5 次独立运行中达到了 98.1 ± 0.8% 的准确率,证明了其在计算生物学之外的泛化能力
进一步的分析表明,生成的 MCP 中没有系统性的捷径学习证据,Paper2Agent 支持在示例中进行模型训练和自适应超参数调整,并且发现 Paper2Agent 在置换的论文-问题基准测试中正确拒绝了 100% 超出范围的查询
Paper agents collaborate for discovery
人类科学合作常常通过结合多篇不同论文中的见解来取得进步——例如,将新开发的方法应用于最近发表的数据集以产生新的发现。作者作为一项探索性案例研究,使用了Paper2Agent生成的三种工具:AlphaGenome,大规模并行报告基因检测(MPRA)偶联的单细胞CRISPR干扰(scCRISPRi)以及T细胞的Perturb-seq以鉴定和验证与银屑病相关的变异的致病基因。
人类研究人员选择了特征相关性分析来检验 CRE 扰动特征是否与任何基因敲低特征相匹配。对于五个排名靠前的候选基因,每个基因都有可用的敲低数据,该agent将扰乱 rs887314 CRE 引起的下游基因表达变化与在三种培养条件下敲低每个候选基因引起的变化进行了关联。
Discussion
并非每篇论文都能无缝转化为强大的Agent. 然而,在作者的大规模评估中,仍有相当一部分存储库无法成功实现代理化,通常是由于代码库不完整、缺少文档或环境配置无法解析。这些挑战表明,将论文转化为代理的难易程度本身可能可以作为可复制性的一个实际衡量标准。
Paper2Agent 是一种增强科学发现和提高论文的获取、可重复性和再利用性的工具,而不是科学结论的独立或权威来源
Paper2Agent 指向的未来是,科学交流不仅是描述结果,而且还要创建体现和扩展研究的交互式、协作实体。
Methods
Paper2Agent 实现详情
Paper2Agent 将研究论文及其公开代码库转换为可用于生产的 MCP 服务器,然后将该服务器暴露给 AI 代理接口。
作者使用 Claude Code 的agent SDK 将其实现为一个多代理系统,其中中央协调agent通过六步流程协调各个专门的子agent。每个子agent都由一个结构化的提示定义,该提示指定了其角色、允许使用的工具(例如,文件读/写、shell 执行和 Web 访问)以及预期的输出模式。
该流程分为六个步骤,数据通过标准化的 JSON 报告和文件规范在各个步骤之间流动:
Locate and download the codebase. Paper2Agent 首先尝试从稿件正文、参考文献或补充材料中自动识别相关的代码库。如果自动识别失败,如果返回多个候选对象,或者如果用户更喜欢指定特定的存储库,则可以直接提供存储库 URL。
Environment setup. 环境管理器子agent为代码库提供了一个干净、隔离的虚拟环境。输入是克隆的代码库,输出是一个隔离的虚拟环境和测试配置文件。
Tutorial discovery. 教程扫描器子agent扫描代码库,查找有用的参考资料和教育材料,并生成工具库候选教程索引。输入包括克隆的代码库和一个可选的教程过滤器。输出是一个 JSON 文件,表示已分类的文件索引。
Tutorial execution and audit. 教程执行器子agent使用示例数据端到端运行选定的教程,捕获输入、输出、数字和运行时约束,并记录任何必须明确说明的隐式假设。输入文件包括教程源文件、已激活的虚拟环境和扫描器报告。输出文件包括已执行的笔记本和每个教程的执行报告。
Tool extraction, testing and refinement. 首先,教程工具提取与实现子代理(tutorial tool extractor–implementor)会将每个已经执行的教程转换为一个独立的 Python 模块,其中包含可复用的函数。它会识别具有通用性的分析步骤,将硬编码的参数(例如文件路径、阈值、列名)进行参数化,强制规定使用基于文件的输入和输出,并将每个函数装饰为一个 MCP 工具。 其次,测试验证与改进子代理(test verifier–improver)会利用教程自带的示例数据作为“真实标准”(ground truth),为每个函数创建对应的测试文件。测试会验证预期的输出文件是否能够成功生成;对于反复测试失败的函数,则移除其 MCP 工具装饰器,并将其排除在最终的 MCP 服务器之外。
MCP server assembly.协调器将所有经过验证的工具模块集成到一个统一的 MCP 服务器中,该服务器具有清单、版本控制和基本安全默认设置,可供协调器或合作科学家agent使用
Agent设定
Environment manager: a specialized agent responsible for creating clean, reproducible environments for research codebases. It analyses project setup requirements, provisions an isolated workspace, installs all necessary dependencies and ensures the code runs without conflicts. Standardizing environment setup enables reliable execution and reproducibility across different systems.
Tutorial scanner: a specialized agent for reviewing the public codebases to identify and organize educational resources. It systematically scans available materials, distinguishes genuine tutorials from other files and highlights those most useful for reuse. The agent then produces clear summaries and reports, providing a structured view of which resources are worth keeping and which can be set aside.
Tutorial executor: executes approved tutorials end-to-end to generate gold-standard outputs and reference data for downstream tool extraction. The agent systematically resolves execution errors, preserves all generated outputs (numerical results, figures, tables) and records execution metadata. The resulting executed notebooks, extracted figures and generated data files serve as authoritative reference material for test creation and validation.
Tutorial tool extractor–implementor: a specialized agent that converts tutorials into reusable tools. It reviews selected tutorials, identifies tasks that generalize beyond the example data and implements each as a clean, single-purpose function with clear inputs, outputs, and defaults. The agent parameterizes hard-coded values, enforces file-based inputs, saves essential results and figures, and returns a standardized summary of produced artefacts. Its goal is to create a practical function library that reproduces tutorial results on the original data while remaining ready to run on new datasets.
Test verifier–improver: a specialized agent that creates, runs and refines tests for tutorial implementations. It uses only the tutorial’s own examples to ensure complete coverage and faithful reproduction of numerical and visualization results. A test passes when expected files are generated, numerical results match tutorial outputs exactly (with a 3% tolerance for floating-point values) and generated figures match reference visualizations (verified via perceptual hashing with Hamming distance < 20). The agent runs in a loop of generating tests, executing them, diagnosing failures and applying fixes, with a maximum of six attempts per function. If functions repeatedly fail, their MCP decorators are removed, a failure comment is added and they will not be included in the MCP server. All results and logs are recorded for transparency.
Generation and analysis of AlphaGenome agent
作者将 Paper2Agent 框架应用于 AlphaGenome 论文,生成了 AlphaGenome MCP,并将该 MCP 与 Claude Code 连接,创建了 AlphaGenome 智能体。生成的 AlphaGenome MCP 服务器远程托管在 Hugging Face Spaces 上(代码可用性)。为了验证可重复性,我们使用 15 个基于教程的原始查询和 15 个新查询对 AlphaGenome agent进行了评估。我们向Agent提出问题,并将agent的响应与真实答案进行比较。
Generation and analysis of TISSUE agent
我们将 Paper2Agent 框架应用于 TISSUE 论文,生成 TISSUE MCP,并将其与 Claude Code 连接,创建 TISSUE 智能体。为了评估可重复性,我们将 TISSUE 智能体的输出与人类研究人员使用相同的鼠体感皮层空间转录组学数据生成的输出进行了比较。人类研究人员根据 TISSUE GitHub 代码库中的教程进行了分析。
Generation and analysis of Scanpy agent
我们将 Paper2Agent 框架应用于 Scanpy 软件包,生成了一个 Scanpy 代理。该代理仅限于 Scanpy 内部的预处理和聚类工作流程,从而为单细胞 RNA 测序分析提供了一个专注且可复现的流程。最终生成的 MCP 服务器被部署并与 Claude Code 集成,从而创建了一个 Scanpy 代理。
对于流程化的Agent,可重复性依然是重中之重
github仓库地址[https://github.com/jmiao24/Paper2Agent/tree/main]
如何使用skills
- 这个仓库不是命令行工具,没有 pip install、没有可执行入口。它的使用范式是:把 skills/paper2agent/ 装进你的编码 agent(Claude Code / Codex),然后用自然语言下指令,由编码 agent 读取技能里的提示词,自己编排子 agent 跑完整个转换流水线。你全程只做三件事:给输入、偶尔答疑、收产物。
| 输入 | 必需性 | 走的分支 |
|---|---|---|
| 论文(PDF / URL / 本地文件) | 可选 | 只给论文 → Paper2Skill(生成 Agent 可读的论文知识包) |
| 代码仓库(GitHub URL / 本地路径) | 可选 | 只给代码 → Paper2MCP(生成可执行的 MCP Server) |
| 两者都给 | 最佳 | 完整的 Paper Agent(方法可执行 + 知识可问答) |
| 输出目录 | 必须 | 存放整个工作区和最终产物 |
- 安装技能
- 方式 A(最简,不装):不 clone 仓库,直接把 README 的 Quick Start 提示词贴给 Claude Code,让它自己去读 GitHub 仓库并完成安装:
Read https://github.com/jmiao24/Paper2Agent and install the paper2agent skill
from skills/paper2agent for this coding agent.- 方式 B(手动):clone 仓库后,把 skills/paper2agent/ 整个目录(含 paper2mcp、paper2skill 等子目录)拷贝到
~/.claude/skills/paper2agent/(Codex 则是~/.agents/skills/paper2agent/),然后重启/新开会话让技能生效
- 在新会话中发起转换
/paper2agent Convert <GITHUB_URL> into tested MCP tools in <PROJECT_DIR>.

# 附加论文文件(完整 agent)
/paper2agent Convert https://github.com/scverse/scanpy into tested MCP tools
in Scanpy_Agent. 论文: <PAPER_URL_OR_LOCAL_FILES>

# 缩小范围(只转某个教程/任务,更快更稳)
... Focus on the "Preprocessing and clustering" tutorial.
# 或直接给教程 URL
... Focus on https://github.com/scverse/scanpy/blob/main/docs/tutorials/basics/clustering.ipynb- 等待——六阶段自动推进
- 环境+工具选择(并行):建隔离虚拟环境、装依赖;同时扫描教程/README/官方测试,决定哪些操作值得封装成工具
- 逐教程执行:每个教程派一个执行器,端到端跑通,把数值、图表、元数据存为“金标准”参考输出
- 实现+独立验证:每个模块一个实现器写最小 wrapper(直接调上游 API,不复制算法);然后全新的验证器(与实现器不同 agent)建测试——完整数值对比、改输入、错误处理,每工具最多 6 轮修复,修不过就剔除
- MCP 集成:把通过验证的工具组装成 server
- 运行时验证:在干净环境重新安装、通过 MCP 协议真实调用
- 文档+交付:生成 USAGE.md,打包 ZIP,由独立交付验证器在新位置解压验收
- 产物
跑完后得到 dist/<仓库名>-mcp.zip,内含
- MCP server 代码(每个工具带指向原仓库 commit 的 REFERENCE 链接)
- USAGE.md:测试过的解释器版本、启动入口、环境变量、支持平台、已验证/被剔除的工具清单
- 连接成你自己的 agent
本地连接:解压 ZIP,按 USAGE.md 装依赖,然后 claude mcp add <名字> –
(stdio 方式);或者偷懒,直接对 agent 说 “Connect the generated MCP server to my coding-agent client using its USAGE.md.” 远端连接(想分享给别人/跨机器用):把 server 部署到 Hugging Face Spaces 等托管平台,别人一句 claude mcp add –transport http <名字> <端点> 就能挂上——官方那三个(AlphaGenome/Scanpy/TISSUE)就是这么发布的
验证:claude mcp list 或会话内 /mcp,出现且能调用即成功